แขกรับเชิญยกเลิกในวันอังคาร สคริปต์เขียนไว้ในรูปบทสนทนาแล้ว และไมโครโฟนเพียงตัวเดียวในห้องก็เป็นของฉัน การเขียนบทสนทนาใหม่ให้เป็นบทพูดคนเดียวจะใช้เวลาหนึ่งชั่วโมง และจะทำให้ตอนนี้แย่ลงด้วย ฉันจึงเลือกอีกทางหนึ่ง: เก็บเสียงพูดสองส่วนไว้ แล้วสร้างเสียงที่สองขึ้นมาใหม่ตั้งแต่ต้น ด้านล่างคือลำดับขั้นตอนที่รอดมาจากการทำสามตอน รวมถึงจุดที่ครั้งแรกพังด้วย
ขั้นที่ 1: ตัดสินใจว่าเสียงของใครอยู่ในตอนนี้
อันดับแรกต้องเลือกว่าจะ
แปลงข้อความเป็นเสียงด้วยเสียงของคุณเอง หรือจะยืมเสียงจากชุมชนให้แขก ทั้งสองทางไปจบที่ตัวแก้ไขเดียวกัน ถ้าเป็นรายการที่ออกลงเป็นประจำ การโคลนเสียงที่เสถียรสักหนึ่งเสียงคุ้มค่ากับห้านาทีนั้น ถ้าทำแค่ตอนเดียว การยืมเร็วกว่า
ตัวอย่างเสียงที่ใส่เข้าไป
หน้า Voice Cloning ต้องการเสียงคนพูดชัดเจนเพียงคนเดียว 5–30 วินาที ในรูป MP3, WAV หรือ M4A ขนาดไม่เกิน 30MB ในทางปฏิบัติ ราวสามสิบวินาทีคือจุดที่พอดีที่สุด หลีกเลี่ยงเพลงพื้นหลัง เสียงพัดลม และคนที่สองในห้อง สามอย่างนี้คือสาเหตุปกติที่ทำให้เสียงโคลนออกมาทึบ หน้าเว็บจะแสดงข้อความที่ถอดเสียงอัตโนมัติให้ตรวจสอบ และขอให้ยืนยันสิทธิ์ก่อนสร้างอะไรก็ตาม ถ้าโคลนเสียงตัวเอง ช่องทำเครื่องหมายนั้นใช้เวลาสิบวินาที ถ้าโคลนเสียงคนอื่น มันควรทำให้คุณหยุดจนกว่าจะมีความยินยอมจริงอยู่ในมือ
ตั้งชื่อก่อนที่จะมีสักสิบเสียง
ตั้งชื่อให้แต่ละบทบาทใน
คลังเสียง AI ส่วนตัวของคุณ เพราะชั้นวางที่เต็มไปด้วยโคลนซึ่งตั้งชื่อตามวันที่ จะใช้ไม่ได้เลยเวลาต้องรีบ My Voices แสดงทุกอย่างภายใต้บัญชี มีปุ่ม Clone a voice และทางลัดเป็นเครื่องหมายบวกในแถบด้านข้าง บัญชีที่ยังว่างจะบอกว่า "No voices yet — clone your first one." เสียงในระดับฟรีเป็นสาธารณะและแชร์ให้ชุมชน ส่วนเสียงส่วนตัวเป็นโควต้าของแพ็กเกจเสียเงิน — Plus ได้ 20, Pro ได้ 100 ของฉันชื่อ "host" กับ "guest B" ไม่ใช่ "recording_03"
ขั้นที่ 2: หาเสียงที่สองที่ฟังได้นาน
ใช้ตัวกรอง ไม่ใช่เลื่อนหน้าจอลงเรื่อย ๆ
Discover เป็นสารบัญสาธารณะ มีช่องค้นหาคำสำคัญ เมนูเลือก All voice languages และแท็กที่เลือกซ้อนกันได้: Professional, Male, Female, Neutral, Young, Middle Aged, Narration, Social Media, ASMR การเรียงลำดับค่าเริ่มต้นคือ Most used การ์ดแสดงธงภาษา แท็กเพศ อายุ และสไตล์ จำนวน Uses กับ Favorites และปุ่ม Use เปิดดูจะได้ตัวอย่างเสียงจริง Voice Overview ที่มีชื่อผู้สร้างกับวันที่เผยแพร่ และลิงก์ Report
กฎการทดลองฟัง
ฟังตัวอย่างด้วยประโยคเดียวกับที่แขกจะพูดจริง ๆ เสียงที่ฟังดูอบอุ่นตอนอ่านย่อหน้าตัวอย่าง อาจฟังดูผิดตอนถามคำถามที่แหลมคม ฉันเก็บผู้เข้ารอบสามเสียง ไม่ใช่สิบห้า และตัดสินหลังฟังเสียงละสองประโยค
ตรึงเสียงที่ชนะ
Favorites รวมเสียงที่เก็บไว้เป็นรายชื่อสั้น ๆ ที่ผูกกับบัญชี — คนที่ยังไม่ล็อกอินจะเห็น Log in / Sign up — และรายชื่อนั้นจะกลับมาเป็นกลุ่ม Favorites ในตัวเลือกเสียงของตัวแก้ไข คู่กับ My voices และ Community ขั้นตอนนี้แหละที่ทำให้ตอนที่สองเร็วกว่าตอนแรก
ขั้นที่ 3: เขียนสคริปต์ให้ตัวแก้ไข ไม่ใช่ให้กระดาษ
ตัวนับของแพ็กเกจฟรีหยุดที่ 150 อักขระต่อการสร้างหนึ่งครั้ง บทสนทนาได้เปรียบกว่าบทบรรยายตรงนี้ เพราะหนึ่งรอบของการสนทนามักจะสั้นกว่าขีดจำกัดนั้นอยู่แล้ว
ทำโครงสร้างให้เห็น
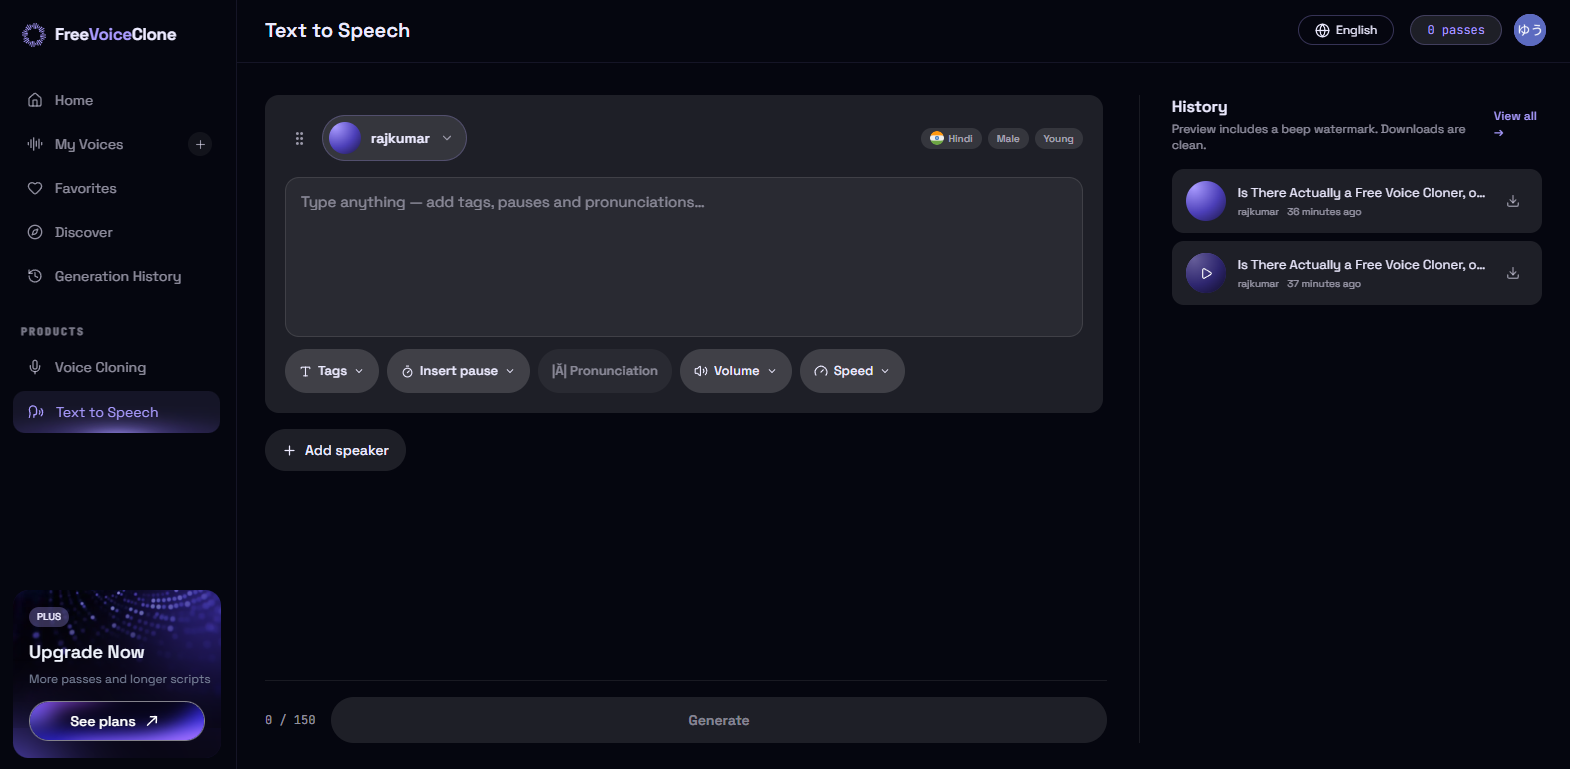
เขียนแต่ละรอบของผู้พูดเป็นส่วนแยกกัน โดยใส่ชื่อผู้พูดไว้ข้างหน้า ตัดตรงเครื่องหมายวรรคตอนเท่านั้น ห้ามตัดกลางอนุประโยค รักษา Volume และ Speed ให้เหมือนกันทุกส่วนของผู้พูดคนเดียว การเปลี่ยนค่าสองตัวนี้ระหว่างรอบคือสิ่งที่ทำให้ตัวละครคนเดียวฟังดูเหมือนสามคน
ใช้ตัวควบคุมที่แบกอารมณ์ไว้
Tags ทำเครื่องหมายให้ประโยคเป็นคำถาม ความประหลาดใจ หรือการยืนยัน Insert pause ใส่ช่องว่างที่ตั้งใจในจุดที่เครื่องหมายจุลภาคยังไม่พอ — มีประโยชน์ก่อนมุกตลก Pronunciation ต้องเลือกข้อความก่อนจึงจะทำงาน และเป็นวิธีเดียวที่เชื่อถือได้สำหรับชื่อแขกหรือชื่อสถานที่ Add speaker คือกลไกสองพิธีกรที่แท้จริง: หนึ่งสคริปต์ สองเสียงที่กำหนดไว้ ไม่ต้องมีไมโครโฟนตัวที่สอง
สร้างเป็นชุดเล็ก ๆ
สร้างครั้งละสี่ถึงหกรอบ แล้วฟังโดยไม่ทำอย่างอื่น ถ้าประโยคหนึ่งฟังดูเรียบ ให้แก้สคริปต์ ไม่ใช่แก้เสียง ประโยคที่เรียบเกือบทุกครั้งคือประโยคที่เขียนไม่ดี
ขั้นที่ 4: เปรียบเทียบก่อนส่งออกอะไรก็ตาม
Generation History เก็บสคริปต์ เสียง ภาษาของผลลัพธ์ และค่าตั้งของทุกครั้งที่ลอง พร้อม Play และ Download ในแต่ละแถว บัญชีที่ยังว่างจะแสดง "No generation history yet." กล่อง Recent generations ในตัวแก้ไขและลิงก์ View all พามาที่นี่
วิธีทดลองฟังที่ใช้ได้จริง
เรียงผลงานสามแบบของบทสนทนาชุดเดียวกันตามลำดับ แล้วฟังด้วยหูฟัง ไม่ใช่ลำโพงแล็ปท็อป ตรวจสามอย่าง: ช่วงหยุดตกหลังคำถามหรือไม่ เสียงสองเสียงยังแยกกันชัดที่ระดับความดังเดียวกันหรือไม่ และการเข้ามาของผู้พูดคนที่สองฟังดูเหมือนการตอบ ไม่ใช่การขึ้นย่อหน้าใหม่ มีเพียงเทคที่ชนะเท่านั้นที่ได้กด Download ทุกการดาวน์โหลดที่สะอาดใช้ download pass ไปหนึ่งครั้ง และ pass ไม่มีวันหมดอายุ จึงไม่มีเหตุผลที่จะส่งออกไฟล์ร่าง "เผื่อไว้ก่อน"
ขั้นที่ 5: จ่ายเงินตรงจุดที่สมเหตุสมผล
เลขที่ไม่ปิดบัง
Free คือ $0 สร้างและฟังตัวอย่างได้ไม่จำกัด 505 ภาษาสำหรับผลลัพธ์ 150 อักขระต่อครั้ง และเสียงสาธารณะ ตัวอย่างมีลายน้ำเป็นเสียง beep Plus คือ $9.99 ต่อเดือน ได้ 50 pass, 3,600 อักขระ, 20 เสียงส่วนตัว และสิทธิ์ใช้งานเชิงพาณิชย์ Pro คือ $49.99 ได้ 120 pass, 15,000 อักขระ และ 100 เสียงส่วนตัว แพ็ก $5.99 แบบจ่ายครั้งเดียวได้ 10 pass โดยไม่ต้องสมัครสมาชิก และจ่ายรายปีประหยัด 20% ตอนสองพิธีกรความยาวยี่สิบนาทีที่เก็บไว้ราวสี่สิบส่วน คือจุดที่การสมัครสมาชิกเริ่มคุ้มกว่าซื้อแพ็ก pass ต่ำกว่านั้น แพ็กชนะ
หน้าแรกเอาไว้ทำอะไร
หน้าแรกของ freevoiceclone จัดทุกอย่างข้างบนให้เป็นสามขั้น และตอบขอบเขตระหว่างฟรีกับเสียเงินไว้ใน FAQ ด้านหลังมัน พื้นผิวทั้งแปดเรียงกันเป็นสายการผลิตเดียว: Home, Voice Cloning, My Voices, Favorites, Discover, Text to Speech, Generation History และ Pricing แต่ละอันถือหนึ่งช่วงของตอนนี้ อ่านสักครั้งก่อนทำตอนแรกมีประโยชน์ ส่วนใหญ่เพื่อไม่ให้เข้าใจผิดว่าแพ็กเกจฟรีเป็นช่วงทดลองที่มีกำหนดเวลา
ขั้นที่ 6: ห้าข้อตรวจก่อนเผยแพร่
ฟังตอนที่ประกอบแล้วตั้งแต่ต้นจนจบ ตรวจว่าไม่มีเสียง beep หลุดไปในไฟล์ที่ส่งมอบ ตรวจว่าชื่อเฉพาะออกเสียงสอดคล้องกันในสองเสียง ตรวจว่าทุกเวอร์ชันภาษาใช้การจัดผู้พูดชุดเดียวกัน — เสียงโคลนหนึ่งเสียงอ่านได้ทุกภาษาที่รองรับ แต่การออกเสียงและความคล้ายต่างกันไปตามภาษา ตรวจว่าตัวสลับภาษาของหน้าตาที่มุมขวาบนไม่ได้ถูกเข้าใจผิดว่าเป็นค่าตั้งภาษาของผลลัพธ์ ตรวจว่าไฟล์สุดท้ายคือเวอร์ชันที่คุณฟังทดสอบในประวัติ ไม่ใช่ไฟล์ร่างเก่าจากโฟลเดอร์ดาวน์โหลด
ครั้งแรกพังตรงไหน
ฉันอัดตัวอย่างเสียงตอนเปิดเพลงเบา ๆ อยู่ในห้อง เสียงโคลนเลยเอาการสั่นเป็นจังหวะจาง ๆ ติดไปทุกประโยค ฉันตัดคำตอบยาว ๆ ของแขกกลางอนุประโยค รอยต่อจึงเห็นชัด ฉันเปลี่ยน Speed ระหว่างสองรอบของผู้พูดคนเดียว คนฟังเลยถามว่ามีคนที่สามมาร่วมด้วยหรือเปล่า สามอย่างล้วนเป็นความผิดพลาดตอนอัดและตัดต่อ ไม่ใช่โมเดลล้มเหลว การอัดใหม่สามสิบวินาทีในห้องเงียบแก้ข้อแรกได้ อีกสองข้อแก้ด้วยกฎข้างบน
ตอนพอดแคสต์สองพิธีกรยังต้องการบทพูดที่เขียนดีสองชุดบนกระดาษอยู่เหมือนเดิม สิ่งที่มันไม่ต้องการอีกต่อไปคือคนที่สองในห้อง ไมโครโฟนตัวที่สอง หรืออีกหนึ่งค่ำคืนที่ต้องอัดใหม่สำหรับประโยคที่จริง ๆ แล้วแค่ต้องการช่วงหยุดสักจังหวะข้างหน้ามัน
พอดแคสต์สองพิธีกรที่ไม่ต้องใช้ไมโครโฟนตัวที่สอง
ขั้นที่ 1: ตัดสินใจว่าเสียงของใครอยู่ในตอนนี้
อันดับแรกต้องเลือกว่าจะ แปลงข้อความเป็นเสียงด้วยเสียงของคุณเอง หรือจะยืมเสียงจากชุมชนให้แขก ทั้งสองทางไปจบที่ตัวแก้ไขเดียวกัน ถ้าเป็นรายการที่ออกลงเป็นประจำ การโคลนเสียงที่เสถียรสักหนึ่งเสียงคุ้มค่ากับห้านาทีนั้น ถ้าทำแค่ตอนเดียว การยืมเร็วกว่า
ตัวอย่างเสียงที่ใส่เข้าไป
หน้า Voice Cloning ต้องการเสียงคนพูดชัดเจนเพียงคนเดียว 5–30 วินาที ในรูป MP3, WAV หรือ M4A ขนาดไม่เกิน 30MB ในทางปฏิบัติ ราวสามสิบวินาทีคือจุดที่พอดีที่สุด หลีกเลี่ยงเพลงพื้นหลัง เสียงพัดลม และคนที่สองในห้อง สามอย่างนี้คือสาเหตุปกติที่ทำให้เสียงโคลนออกมาทึบ หน้าเว็บจะแสดงข้อความที่ถอดเสียงอัตโนมัติให้ตรวจสอบ และขอให้ยืนยันสิทธิ์ก่อนสร้างอะไรก็ตาม ถ้าโคลนเสียงตัวเอง ช่องทำเครื่องหมายนั้นใช้เวลาสิบวินาที ถ้าโคลนเสียงคนอื่น มันควรทำให้คุณหยุดจนกว่าจะมีความยินยอมจริงอยู่ในมือ
ตั้งชื่อก่อนที่จะมีสักสิบเสียง
ตั้งชื่อให้แต่ละบทบาทใน คลังเสียง AI ส่วนตัวของคุณ เพราะชั้นวางที่เต็มไปด้วยโคลนซึ่งตั้งชื่อตามวันที่ จะใช้ไม่ได้เลยเวลาต้องรีบ My Voices แสดงทุกอย่างภายใต้บัญชี มีปุ่ม Clone a voice และทางลัดเป็นเครื่องหมายบวกในแถบด้านข้าง บัญชีที่ยังว่างจะบอกว่า "No voices yet — clone your first one." เสียงในระดับฟรีเป็นสาธารณะและแชร์ให้ชุมชน ส่วนเสียงส่วนตัวเป็นโควต้าของแพ็กเกจเสียเงิน — Plus ได้ 20, Pro ได้ 100 ของฉันชื่อ "host" กับ "guest B" ไม่ใช่ "recording_03"
ขั้นที่ 2: หาเสียงที่สองที่ฟังได้นาน
ใช้ตัวกรอง ไม่ใช่เลื่อนหน้าจอลงเรื่อย ๆ
Discover เป็นสารบัญสาธารณะ มีช่องค้นหาคำสำคัญ เมนูเลือก All voice languages และแท็กที่เลือกซ้อนกันได้: Professional, Male, Female, Neutral, Young, Middle Aged, Narration, Social Media, ASMR การเรียงลำดับค่าเริ่มต้นคือ Most used การ์ดแสดงธงภาษา แท็กเพศ อายุ และสไตล์ จำนวน Uses กับ Favorites และปุ่ม Use เปิดดูจะได้ตัวอย่างเสียงจริง Voice Overview ที่มีชื่อผู้สร้างกับวันที่เผยแพร่ และลิงก์ Report
กฎการทดลองฟัง
ฟังตัวอย่างด้วยประโยคเดียวกับที่แขกจะพูดจริง ๆ เสียงที่ฟังดูอบอุ่นตอนอ่านย่อหน้าตัวอย่าง อาจฟังดูผิดตอนถามคำถามที่แหลมคม ฉันเก็บผู้เข้ารอบสามเสียง ไม่ใช่สิบห้า และตัดสินหลังฟังเสียงละสองประโยค
ตรึงเสียงที่ชนะ
Favorites รวมเสียงที่เก็บไว้เป็นรายชื่อสั้น ๆ ที่ผูกกับบัญชี — คนที่ยังไม่ล็อกอินจะเห็น Log in / Sign up — และรายชื่อนั้นจะกลับมาเป็นกลุ่ม Favorites ในตัวเลือกเสียงของตัวแก้ไข คู่กับ My voices และ Community ขั้นตอนนี้แหละที่ทำให้ตอนที่สองเร็วกว่าตอนแรก
ขั้นที่ 3: เขียนสคริปต์ให้ตัวแก้ไข ไม่ใช่ให้กระดาษ
ตัวนับของแพ็กเกจฟรีหยุดที่ 150 อักขระต่อการสร้างหนึ่งครั้ง บทสนทนาได้เปรียบกว่าบทบรรยายตรงนี้ เพราะหนึ่งรอบของการสนทนามักจะสั้นกว่าขีดจำกัดนั้นอยู่แล้ว
ทำโครงสร้างให้เห็น
เขียนแต่ละรอบของผู้พูดเป็นส่วนแยกกัน โดยใส่ชื่อผู้พูดไว้ข้างหน้า ตัดตรงเครื่องหมายวรรคตอนเท่านั้น ห้ามตัดกลางอนุประโยค รักษา Volume และ Speed ให้เหมือนกันทุกส่วนของผู้พูดคนเดียว การเปลี่ยนค่าสองตัวนี้ระหว่างรอบคือสิ่งที่ทำให้ตัวละครคนเดียวฟังดูเหมือนสามคน
ใช้ตัวควบคุมที่แบกอารมณ์ไว้
Tags ทำเครื่องหมายให้ประโยคเป็นคำถาม ความประหลาดใจ หรือการยืนยัน Insert pause ใส่ช่องว่างที่ตั้งใจในจุดที่เครื่องหมายจุลภาคยังไม่พอ — มีประโยชน์ก่อนมุกตลก Pronunciation ต้องเลือกข้อความก่อนจึงจะทำงาน และเป็นวิธีเดียวที่เชื่อถือได้สำหรับชื่อแขกหรือชื่อสถานที่ Add speaker คือกลไกสองพิธีกรที่แท้จริง: หนึ่งสคริปต์ สองเสียงที่กำหนดไว้ ไม่ต้องมีไมโครโฟนตัวที่สอง
สร้างเป็นชุดเล็ก ๆ
สร้างครั้งละสี่ถึงหกรอบ แล้วฟังโดยไม่ทำอย่างอื่น ถ้าประโยคหนึ่งฟังดูเรียบ ให้แก้สคริปต์ ไม่ใช่แก้เสียง ประโยคที่เรียบเกือบทุกครั้งคือประโยคที่เขียนไม่ดี
ขั้นที่ 4: เปรียบเทียบก่อนส่งออกอะไรก็ตาม
Generation History เก็บสคริปต์ เสียง ภาษาของผลลัพธ์ และค่าตั้งของทุกครั้งที่ลอง พร้อม Play และ Download ในแต่ละแถว บัญชีที่ยังว่างจะแสดง "No generation history yet." กล่อง Recent generations ในตัวแก้ไขและลิงก์ View all พามาที่นี่
วิธีทดลองฟังที่ใช้ได้จริง
เรียงผลงานสามแบบของบทสนทนาชุดเดียวกันตามลำดับ แล้วฟังด้วยหูฟัง ไม่ใช่ลำโพงแล็ปท็อป ตรวจสามอย่าง: ช่วงหยุดตกหลังคำถามหรือไม่ เสียงสองเสียงยังแยกกันชัดที่ระดับความดังเดียวกันหรือไม่ และการเข้ามาของผู้พูดคนที่สองฟังดูเหมือนการตอบ ไม่ใช่การขึ้นย่อหน้าใหม่ มีเพียงเทคที่ชนะเท่านั้นที่ได้กด Download ทุกการดาวน์โหลดที่สะอาดใช้ download pass ไปหนึ่งครั้ง และ pass ไม่มีวันหมดอายุ จึงไม่มีเหตุผลที่จะส่งออกไฟล์ร่าง "เผื่อไว้ก่อน"
ขั้นที่ 5: จ่ายเงินตรงจุดที่สมเหตุสมผล
เลขที่ไม่ปิดบัง
Free คือ $0 สร้างและฟังตัวอย่างได้ไม่จำกัด 505 ภาษาสำหรับผลลัพธ์ 150 อักขระต่อครั้ง และเสียงสาธารณะ ตัวอย่างมีลายน้ำเป็นเสียง beep Plus คือ $9.99 ต่อเดือน ได้ 50 pass, 3,600 อักขระ, 20 เสียงส่วนตัว และสิทธิ์ใช้งานเชิงพาณิชย์ Pro คือ $49.99 ได้ 120 pass, 15,000 อักขระ และ 100 เสียงส่วนตัว แพ็ก $5.99 แบบจ่ายครั้งเดียวได้ 10 pass โดยไม่ต้องสมัครสมาชิก และจ่ายรายปีประหยัด 20% ตอนสองพิธีกรความยาวยี่สิบนาทีที่เก็บไว้ราวสี่สิบส่วน คือจุดที่การสมัครสมาชิกเริ่มคุ้มกว่าซื้อแพ็ก pass ต่ำกว่านั้น แพ็กชนะ
หน้าแรกเอาไว้ทำอะไร
หน้าแรกของ freevoiceclone จัดทุกอย่างข้างบนให้เป็นสามขั้น และตอบขอบเขตระหว่างฟรีกับเสียเงินไว้ใน FAQ ด้านหลังมัน พื้นผิวทั้งแปดเรียงกันเป็นสายการผลิตเดียว: Home, Voice Cloning, My Voices, Favorites, Discover, Text to Speech, Generation History และ Pricing แต่ละอันถือหนึ่งช่วงของตอนนี้ อ่านสักครั้งก่อนทำตอนแรกมีประโยชน์ ส่วนใหญ่เพื่อไม่ให้เข้าใจผิดว่าแพ็กเกจฟรีเป็นช่วงทดลองที่มีกำหนดเวลา
ขั้นที่ 6: ห้าข้อตรวจก่อนเผยแพร่
ฟังตอนที่ประกอบแล้วตั้งแต่ต้นจนจบ ตรวจว่าไม่มีเสียง beep หลุดไปในไฟล์ที่ส่งมอบ ตรวจว่าชื่อเฉพาะออกเสียงสอดคล้องกันในสองเสียง ตรวจว่าทุกเวอร์ชันภาษาใช้การจัดผู้พูดชุดเดียวกัน — เสียงโคลนหนึ่งเสียงอ่านได้ทุกภาษาที่รองรับ แต่การออกเสียงและความคล้ายต่างกันไปตามภาษา ตรวจว่าตัวสลับภาษาของหน้าตาที่มุมขวาบนไม่ได้ถูกเข้าใจผิดว่าเป็นค่าตั้งภาษาของผลลัพธ์ ตรวจว่าไฟล์สุดท้ายคือเวอร์ชันที่คุณฟังทดสอบในประวัติ ไม่ใช่ไฟล์ร่างเก่าจากโฟลเดอร์ดาวน์โหลด
ครั้งแรกพังตรงไหน
ฉันอัดตัวอย่างเสียงตอนเปิดเพลงเบา ๆ อยู่ในห้อง เสียงโคลนเลยเอาการสั่นเป็นจังหวะจาง ๆ ติดไปทุกประโยค ฉันตัดคำตอบยาว ๆ ของแขกกลางอนุประโยค รอยต่อจึงเห็นชัด ฉันเปลี่ยน Speed ระหว่างสองรอบของผู้พูดคนเดียว คนฟังเลยถามว่ามีคนที่สามมาร่วมด้วยหรือเปล่า สามอย่างล้วนเป็นความผิดพลาดตอนอัดและตัดต่อ ไม่ใช่โมเดลล้มเหลว การอัดใหม่สามสิบวินาทีในห้องเงียบแก้ข้อแรกได้ อีกสองข้อแก้ด้วยกฎข้างบน
ตอนพอดแคสต์สองพิธีกรยังต้องการบทพูดที่เขียนดีสองชุดบนกระดาษอยู่เหมือนเดิม สิ่งที่มันไม่ต้องการอีกต่อไปคือคนที่สองในห้อง ไมโครโฟนตัวที่สอง หรืออีกหนึ่งค่ำคืนที่ต้องอัดใหม่สำหรับประโยคที่จริง ๆ แล้วแค่ต้องการช่วงหยุดสักจังหวะข้างหน้ามัน