จุดเปลี่ยนวงการภาพยนตร์และหุ่นยนต์เชิงกายภาพ บ.เอไอจีน เปิดตัว ‘Atlas’ สร้างฉาก 3D จากภาพไม่กี่ใบ - คุมมุมกล้องได้ - คิดฉากต่อเนื่องให้ได้
.
World Labs สตาร์ตอัปด้านปัญญาประดิษฐ์ชั้นนำ ประกาศเปิดตัว “Atlas” นวัตกรรมโมเดลจำลองโลกหลายรูปแบบที่มีความสามารถด้านความเข้าใจเชิงพื้นที่ของ AI แบบก้าวกระโดด โดดเด่นด้วยเทคโนโลยี Camera Controlled Generation ที่ช่วยสร้างวิดีโอและฟื้นฟูฉาก 3 มิติที่สมบูรณ์ได้จากภาพถ่ายภาคพื้นดินเพียงไม่กี่ภาพ พร้อมคำนวณการตอบสนองทางกายภาพได้อย่างสมจริง กล่าวได้ว่าเป็นอีกหนึ่งจุดเปลี่ยนสำคัญของอุตสาหกรรมภาพยนตร์
.
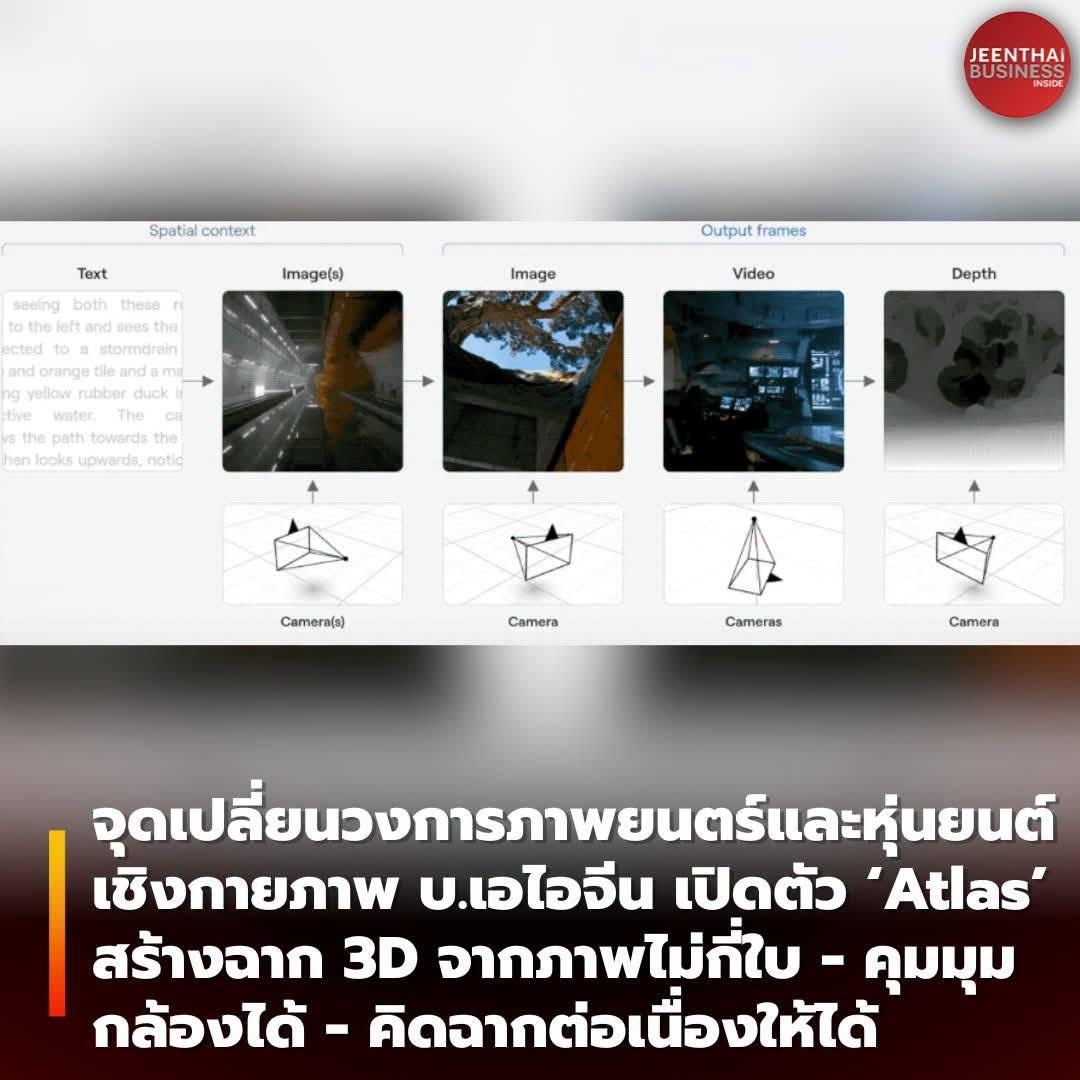
World Labs ก่อตั้งโดยหลี่เฟยเฟย นักวิทยาศาสตร์คอมพิวเตอร์ชั้นนำและผู้เชี่ยวชาญด้าน Computer Vision จากมหาวิทยาลัยสแตนฟอร์ด โดย “Atlas” ซึ่งเป็น World Model แบบหลายรูปแบบ ที่สามารถสามารถประมวลผลทั้งข้อความ ภาพ วิดีโอ ตำแหน่งและทิศทางของกล้อง รวมถึงข้อมูลความลึก 3 มิติได้ในโมเดลเดียว พร้อมผสานความสามารถด้านการสร้างโลกจำลอง การสร้างพื้นที่ 3 มิติขึ้นใหม่ และการจำลองการเปลี่ยนแปลงของพื้นที่ตามเวลา
.
ความสามารถที่โดดเด่นที่สุดคือ Camera Controlled Generation หรือการสร้างภาพและวิดีโอตามการควบคุมกล้อง ซึ่งแตกต่างจากโมเดลสร้างวิดีโอทั่วไปที่ผู้ใช้ต้องอาศัย Prompt เพื่อบรรยายมุมกล้องและการเคลื่อนที่อย่างละเอียด เช่น ให้กล้องค่อยๆ เคลื่อนไปทางซ้าย ยกสูงขึ้น หรือหมุนรอบตัวแบบ จากนั้นจึงต้องรอดูว่าผลลัพธ์ที่ AI สร้างขึ้นจะตรงกับมุมมองที่ต้องการมากน้อยเพียงใด
.
Atlas สามารถรับข้อมูลตำแหน่งและทิศทางของกล้องเป็นข้อมูลนำเข้าโดยตรง ผู้ใช้จึงกำหนดมุมกล้อง เส้นทาง และความเร็วในการเคลื่อนกล้องได้ เพียงป้อนภาพถ่ายทั่วไป 1-6 ภาพและกำหนดเส้นทางกล้อง Atlas ก็สามารถสร้างวิดีโอความยาวสูงสุด 1 นาที ความละเอียด 1440p พร้อมรักษาความต่อเนื่องของพื้นที่และรูปทรงวัตถุได้
.
อีกจุดเด่นคือความสามารถในการ คาดการณ์และเติมพื้นที่ที่อยู่นอกภาพ เช่น จากภาพด้านหน้าของหุ่นยนต์ สามารถสร้างมุมมองด้านหลังขึ้นมาได้ หรือจากภาพบางส่วนของสระว่ายน้ำ สามารถเติมสนามหญ้าและภูเขาที่อยู่นอกเฟรมได้
.
อย่างไรก็ตาม พื้นที่ที่ไม่ได้ปรากฏในภาพจริงยังต้องอาศัยข้อมูลที่โมเดลเรียนรู้มาเพื่อคาดการณ์ ดังนั้นเมื่อมุมกล้องเปลี่ยนมากหรือเส้นทางการเคลื่อนที่ยาวขึ้น ก็อาจเกิดความคลาดเคลื่อนของรูปทรง พื้นผิว หรือรายละเอียดบางส่วนได้
.
โมเดลนี้มุ่งสร้าง โลก 3 มิติที่มีความสมเหตุสมผลทางภาพ แต่ไม่ได้หมายความว่าจะสามารถจำลองโลกจริงต้นฉบับได้อย่างแม่นยำทุกจุด เบื้องหลังคือแนวคิด Spatial Context (บริบทเชิงพื้นที่) โดยกำหนดพิกัด 3 มิติและข้อมูลความลึกให้กับภาพแต่ละภาพ เพื่อทำความเข้าใจตำแหน่งและโครงสร้างของพื้นที่ พร้อมใช้ การสังเคราะห์ภาพจากหลายมุมมองเป็นพื้นฐานสำคัญในการสร้างฉาก
.
ระบบจะนำภาพและวิดีโอจากมุมกล้องต่างๆ มาประกอบในพื้นที่ 3 มิติเดียวกัน วิเคราะห์ตำแหน่งที่สัมพันธ์กัน และเติมเต็มส่วนที่ไม่ได้ถูกบันทึกไว้เพื่อสร้างมุมมองใหม่ หากมีเพียงภาพเดียว โมเดลจะอาศัยข้อมูลที่เรียนรู้มาเพื่อคาดการณ์ส่วนที่หายไป แต่เมื่อมีภาพจากหลายมุม ก็สามารถผสานข้อมูลภายใต้ข้อจำกัดด้านพื้นที่และค่อยๆ สร้างเป็นฉาก 3 มิติที่ต่อเนื่องและเปลี่ยนมุมมองได้
.
แม้แต่ภาพถ่าย 2 ภาพที่แทบไม่มีความเกี่ยวข้องกัน ระบบก็สามารถนำมาวางในพื้นที่ 3 มิติ แล้วคาดการณ์ส่วนที่ขาดหาย เช่น ทางเดิน ประตู และห้อง เพื่อเชื่อมฉากทั้งสองเข้าด้วยกันอย่างต่อเนื่อง ทำให้ในอนาคตการสร้างฉากและกำหนดเส้นทางกล้องอาจทำได้โดยไม่ต้องถ่ายทำจริงทุกขั้นตอน
.
นอกจากนี้ Atlas ยังมีความสามารถในการสร้างพื้นที่ 3 มิติขึ้นใหม่ (Spatial Reconstruction) ซึ่งแตกต่างจากเทคนิค 3D Gaussian Splatting แบบเดิม ที่ใช้จุดข้อมูลจำนวนมากเพื่อสร้างฉาก 3 มิติที่มองได้จากหลายมุม โดยวิธีดั้งเดิมต้องใช้อุปกรณ์เฉพาะทางและถ่ายภาพรอบพื้นที่หลายร้อยถึงหลายพันภาพ ขณะที่ Atlas ใช้เพียงภาพถ่ายภาคพื้นดินจากมุมมองทั่วไป 2-25 ภาพ
.
ระบบยังสามารถยกมุมกล้องขึ้นเพื่อสร้างภาพมุมสูงเสมือนการถ่ายจากอากาศได้ โดยทีมพัฒนาได้นำไปทดสอบกับฐานข้อมูลภาพ 3 มิติหลายชุด เช่น DTU, ETH3D และ ScanNet เพื่อวัดความแม่นยำในการสร้างพื้นที่ 3 มิติจากภาพเพียงไม่กี่มุม ผลทดสอบ Atlas ได้คะแนน 25.3 (ยิ่งต่ำยิ่งแม่นยำ) ขณะที่ Pi3X อยู่ที่ 28.7, Depth Anything 3 ที่ 39.3 และ MapAnything ที่ 47.7
.
นอกจากนี้ ผลลัพธ์ยังสามารถนำไปสร้าง Point Cloud และฉาก 3 มิติด้วยเทคนิค 3D Gaussian Splatting ก่อนนำไปแสดงผลบนแพลตฟอร์ม Marble ของ World Labs ได้อย่างรวดเร็ว
.
อีกความสามารถคือ Reframing Video ที่ช่วยเปลี่ยนมุมกล้องของวิดีโอหลังถ่ายทำ เพียงใช้โทรศัพท์หรือกล้องแอ็กชันไม่กี่ตัวบันทึกฉากไว้ ระบบก็สามารถสร้างมุมมองใหม่จากวิดีโอเดิมได้ โดยไม่ต้องใช้กล้องจำนวนมากแบบการถ่ายฉาก “กระสุนหยุดเวลา” ในภาพยนตร์ The Matrix
.
เป้าหมายของหลี่เฟยเฟยและ World Labs ไม่ได้จำกัดอยู่แค่การสร้างวิดีโอหรือเทคโนโลยีสำหรับงานภาพยนตร์ แต่ยังมุ่งแก้โจทย์สำคัญของ Embodied AI หรือ AI ที่สามารถรับรู้และโต้ตอบกับโลกจริงผ่านร่างกาย เช่น หุ่นยนต์ ปัจจุบันการฝึกหุ่นยนต์ยังมีข้อจำกัด เพราะการให้หุ่นยนต์ทดลองทำงานซ้ำๆ ในโรงงาน โกดัง หรือบ้านจริงใช้เวลานานและมีต้นทุนสูง ขณะที่การฝึกในสภาพแวดล้อมจำลองก็ต้องใช้แรงงานจำนวนมากในการสร้างฉาก 3 มิติ วัสดุ แสง และวัตถุต่างๆ ให้ใกล้เคียงโลกจริง
.
World Labs จึงนำเสนอแนวทาง Real-to-Sim หรือการเปลี่ยนสภาพแวดล้อมจริงให้เป็นโลกจำลอง เพียงใช้โทรศัพท์บันทึกวิดีโอจากโรงงานหรือห้องต่างๆ แล้วป้อนเข้าสู่ระบบ ก็สามารถสร้างพื้นที่ 3 มิติที่มีรายละเอียดสูงขึ้นมาได้ หุ่นยนต์จึงสามารถเข้าไปฝึกและทดลองทำภารกิจต่างๆ ในสภาพแวดล้อมจำลองได้ซ้ำๆ โดยไม่ต้องนำไปทดลองในสถานที่จริงทุกครั้ง ช่วยลดเวลา ค่าใช้จ่าย และความเสี่ยงในการเก็บข้อมูลเพื่อฝึกหุ่นยนต์
.
ระบบยังสามารถจำลองสิ่งที่หุ่นยนต์มองเห็นผ่านกล้องติดตัว ทั้งภาพสี RGB และข้อมูลระยะความลึกของวัตถุ (Depth Map) รวมถึงจำลองการตอบสนองทางกายภาพ เช่น แขนกลผลักกล่องแข็ง เปิดประตูตู้ที่มีบานพับ หรือบีบฟองน้ำนิ่ม เพื่อคาดการณ์แรงและการเปลี่ยนแปลงที่เกิดขึ้นได้ เพียงบันทึกวิดีโอจากสถานที่จริงครั้งเดียว ก็สามารถนำไปสร้างสถานการณ์จำลองที่แตกต่างกันได้อีกมากมาย ทั้งสภาพแสง ตำแหน่งวัตถุ และสิ่งกีดขวาง
.
เบื้องหลังความสามารถเหล่านี้คือ Multimodal Autoregressive Diffusion Transformer ซึ่งเป็นโครงสร้าง AI ที่ผสานเทคโนโลยีการประมวลผลข้อมูลหลายรูปแบบเข้ากับเทคนิค Diffusion ทำให้สามารถทำความเข้าใจข้อมูลหลายประเภทพร้อมกัน และนำข้อมูลเหล่านั้นมาสร้างหรือจำลองโลก 3 มิติที่มีความต่อเนื่องได้
.
(อ่านต่อในคอมเมนต์)
.
📧 ติดต่อเรา Email: info@jeenthainews.com
.
#WorldLabs #Atlas #AI
.
https://www.facebook.com/share/p/1HNyRhxb5U/
🎥📽️จุดเปลี่ยนวงการภาพยนตร์และหุ่นยนต์เชิงกายภาพ บ.เอไอจีน เปิดตัว ‘Atlas’ สร้างฉาก 3D จากภาพไม่กี่ใบ - คุมมุมกล้องได้
.
World Labs สตาร์ตอัปด้านปัญญาประดิษฐ์ชั้นนำ ประกาศเปิดตัว “Atlas” นวัตกรรมโมเดลจำลองโลกหลายรูปแบบที่มีความสามารถด้านความเข้าใจเชิงพื้นที่ของ AI แบบก้าวกระโดด โดดเด่นด้วยเทคโนโลยี Camera Controlled Generation ที่ช่วยสร้างวิดีโอและฟื้นฟูฉาก 3 มิติที่สมบูรณ์ได้จากภาพถ่ายภาคพื้นดินเพียงไม่กี่ภาพ พร้อมคำนวณการตอบสนองทางกายภาพได้อย่างสมจริง กล่าวได้ว่าเป็นอีกหนึ่งจุดเปลี่ยนสำคัญของอุตสาหกรรมภาพยนตร์
.
World Labs ก่อตั้งโดยหลี่เฟยเฟย นักวิทยาศาสตร์คอมพิวเตอร์ชั้นนำและผู้เชี่ยวชาญด้าน Computer Vision จากมหาวิทยาลัยสแตนฟอร์ด โดย “Atlas” ซึ่งเป็น World Model แบบหลายรูปแบบ ที่สามารถสามารถประมวลผลทั้งข้อความ ภาพ วิดีโอ ตำแหน่งและทิศทางของกล้อง รวมถึงข้อมูลความลึก 3 มิติได้ในโมเดลเดียว พร้อมผสานความสามารถด้านการสร้างโลกจำลอง การสร้างพื้นที่ 3 มิติขึ้นใหม่ และการจำลองการเปลี่ยนแปลงของพื้นที่ตามเวลา
.
ความสามารถที่โดดเด่นที่สุดคือ Camera Controlled Generation หรือการสร้างภาพและวิดีโอตามการควบคุมกล้อง ซึ่งแตกต่างจากโมเดลสร้างวิดีโอทั่วไปที่ผู้ใช้ต้องอาศัย Prompt เพื่อบรรยายมุมกล้องและการเคลื่อนที่อย่างละเอียด เช่น ให้กล้องค่อยๆ เคลื่อนไปทางซ้าย ยกสูงขึ้น หรือหมุนรอบตัวแบบ จากนั้นจึงต้องรอดูว่าผลลัพธ์ที่ AI สร้างขึ้นจะตรงกับมุมมองที่ต้องการมากน้อยเพียงใด
.
Atlas สามารถรับข้อมูลตำแหน่งและทิศทางของกล้องเป็นข้อมูลนำเข้าโดยตรง ผู้ใช้จึงกำหนดมุมกล้อง เส้นทาง และความเร็วในการเคลื่อนกล้องได้ เพียงป้อนภาพถ่ายทั่วไป 1-6 ภาพและกำหนดเส้นทางกล้อง Atlas ก็สามารถสร้างวิดีโอความยาวสูงสุด 1 นาที ความละเอียด 1440p พร้อมรักษาความต่อเนื่องของพื้นที่และรูปทรงวัตถุได้
.
อีกจุดเด่นคือความสามารถในการ คาดการณ์และเติมพื้นที่ที่อยู่นอกภาพ เช่น จากภาพด้านหน้าของหุ่นยนต์ สามารถสร้างมุมมองด้านหลังขึ้นมาได้ หรือจากภาพบางส่วนของสระว่ายน้ำ สามารถเติมสนามหญ้าและภูเขาที่อยู่นอกเฟรมได้
.
อย่างไรก็ตาม พื้นที่ที่ไม่ได้ปรากฏในภาพจริงยังต้องอาศัยข้อมูลที่โมเดลเรียนรู้มาเพื่อคาดการณ์ ดังนั้นเมื่อมุมกล้องเปลี่ยนมากหรือเส้นทางการเคลื่อนที่ยาวขึ้น ก็อาจเกิดความคลาดเคลื่อนของรูปทรง พื้นผิว หรือรายละเอียดบางส่วนได้
.
โมเดลนี้มุ่งสร้าง โลก 3 มิติที่มีความสมเหตุสมผลทางภาพ แต่ไม่ได้หมายความว่าจะสามารถจำลองโลกจริงต้นฉบับได้อย่างแม่นยำทุกจุด เบื้องหลังคือแนวคิด Spatial Context (บริบทเชิงพื้นที่) โดยกำหนดพิกัด 3 มิติและข้อมูลความลึกให้กับภาพแต่ละภาพ เพื่อทำความเข้าใจตำแหน่งและโครงสร้างของพื้นที่ พร้อมใช้ การสังเคราะห์ภาพจากหลายมุมมองเป็นพื้นฐานสำคัญในการสร้างฉาก
.
ระบบจะนำภาพและวิดีโอจากมุมกล้องต่างๆ มาประกอบในพื้นที่ 3 มิติเดียวกัน วิเคราะห์ตำแหน่งที่สัมพันธ์กัน และเติมเต็มส่วนที่ไม่ได้ถูกบันทึกไว้เพื่อสร้างมุมมองใหม่ หากมีเพียงภาพเดียว โมเดลจะอาศัยข้อมูลที่เรียนรู้มาเพื่อคาดการณ์ส่วนที่หายไป แต่เมื่อมีภาพจากหลายมุม ก็สามารถผสานข้อมูลภายใต้ข้อจำกัดด้านพื้นที่และค่อยๆ สร้างเป็นฉาก 3 มิติที่ต่อเนื่องและเปลี่ยนมุมมองได้
.
แม้แต่ภาพถ่าย 2 ภาพที่แทบไม่มีความเกี่ยวข้องกัน ระบบก็สามารถนำมาวางในพื้นที่ 3 มิติ แล้วคาดการณ์ส่วนที่ขาดหาย เช่น ทางเดิน ประตู และห้อง เพื่อเชื่อมฉากทั้งสองเข้าด้วยกันอย่างต่อเนื่อง ทำให้ในอนาคตการสร้างฉากและกำหนดเส้นทางกล้องอาจทำได้โดยไม่ต้องถ่ายทำจริงทุกขั้นตอน
.
นอกจากนี้ Atlas ยังมีความสามารถในการสร้างพื้นที่ 3 มิติขึ้นใหม่ (Spatial Reconstruction) ซึ่งแตกต่างจากเทคนิค 3D Gaussian Splatting แบบเดิม ที่ใช้จุดข้อมูลจำนวนมากเพื่อสร้างฉาก 3 มิติที่มองได้จากหลายมุม โดยวิธีดั้งเดิมต้องใช้อุปกรณ์เฉพาะทางและถ่ายภาพรอบพื้นที่หลายร้อยถึงหลายพันภาพ ขณะที่ Atlas ใช้เพียงภาพถ่ายภาคพื้นดินจากมุมมองทั่วไป 2-25 ภาพ
.
ระบบยังสามารถยกมุมกล้องขึ้นเพื่อสร้างภาพมุมสูงเสมือนการถ่ายจากอากาศได้ โดยทีมพัฒนาได้นำไปทดสอบกับฐานข้อมูลภาพ 3 มิติหลายชุด เช่น DTU, ETH3D และ ScanNet เพื่อวัดความแม่นยำในการสร้างพื้นที่ 3 มิติจากภาพเพียงไม่กี่มุม ผลทดสอบ Atlas ได้คะแนน 25.3 (ยิ่งต่ำยิ่งแม่นยำ) ขณะที่ Pi3X อยู่ที่ 28.7, Depth Anything 3 ที่ 39.3 และ MapAnything ที่ 47.7
.
นอกจากนี้ ผลลัพธ์ยังสามารถนำไปสร้าง Point Cloud และฉาก 3 มิติด้วยเทคนิค 3D Gaussian Splatting ก่อนนำไปแสดงผลบนแพลตฟอร์ม Marble ของ World Labs ได้อย่างรวดเร็ว
.
อีกความสามารถคือ Reframing Video ที่ช่วยเปลี่ยนมุมกล้องของวิดีโอหลังถ่ายทำ เพียงใช้โทรศัพท์หรือกล้องแอ็กชันไม่กี่ตัวบันทึกฉากไว้ ระบบก็สามารถสร้างมุมมองใหม่จากวิดีโอเดิมได้ โดยไม่ต้องใช้กล้องจำนวนมากแบบการถ่ายฉาก “กระสุนหยุดเวลา” ในภาพยนตร์ The Matrix
.
เป้าหมายของหลี่เฟยเฟยและ World Labs ไม่ได้จำกัดอยู่แค่การสร้างวิดีโอหรือเทคโนโลยีสำหรับงานภาพยนตร์ แต่ยังมุ่งแก้โจทย์สำคัญของ Embodied AI หรือ AI ที่สามารถรับรู้และโต้ตอบกับโลกจริงผ่านร่างกาย เช่น หุ่นยนต์ ปัจจุบันการฝึกหุ่นยนต์ยังมีข้อจำกัด เพราะการให้หุ่นยนต์ทดลองทำงานซ้ำๆ ในโรงงาน โกดัง หรือบ้านจริงใช้เวลานานและมีต้นทุนสูง ขณะที่การฝึกในสภาพแวดล้อมจำลองก็ต้องใช้แรงงานจำนวนมากในการสร้างฉาก 3 มิติ วัสดุ แสง และวัตถุต่างๆ ให้ใกล้เคียงโลกจริง
.
World Labs จึงนำเสนอแนวทาง Real-to-Sim หรือการเปลี่ยนสภาพแวดล้อมจริงให้เป็นโลกจำลอง เพียงใช้โทรศัพท์บันทึกวิดีโอจากโรงงานหรือห้องต่างๆ แล้วป้อนเข้าสู่ระบบ ก็สามารถสร้างพื้นที่ 3 มิติที่มีรายละเอียดสูงขึ้นมาได้ หุ่นยนต์จึงสามารถเข้าไปฝึกและทดลองทำภารกิจต่างๆ ในสภาพแวดล้อมจำลองได้ซ้ำๆ โดยไม่ต้องนำไปทดลองในสถานที่จริงทุกครั้ง ช่วยลดเวลา ค่าใช้จ่าย และความเสี่ยงในการเก็บข้อมูลเพื่อฝึกหุ่นยนต์
.
ระบบยังสามารถจำลองสิ่งที่หุ่นยนต์มองเห็นผ่านกล้องติดตัว ทั้งภาพสี RGB และข้อมูลระยะความลึกของวัตถุ (Depth Map) รวมถึงจำลองการตอบสนองทางกายภาพ เช่น แขนกลผลักกล่องแข็ง เปิดประตูตู้ที่มีบานพับ หรือบีบฟองน้ำนิ่ม เพื่อคาดการณ์แรงและการเปลี่ยนแปลงที่เกิดขึ้นได้ เพียงบันทึกวิดีโอจากสถานที่จริงครั้งเดียว ก็สามารถนำไปสร้างสถานการณ์จำลองที่แตกต่างกันได้อีกมากมาย ทั้งสภาพแสง ตำแหน่งวัตถุ และสิ่งกีดขวาง
.
เบื้องหลังความสามารถเหล่านี้คือ Multimodal Autoregressive Diffusion Transformer ซึ่งเป็นโครงสร้าง AI ที่ผสานเทคโนโลยีการประมวลผลข้อมูลหลายรูปแบบเข้ากับเทคนิค Diffusion ทำให้สามารถทำความเข้าใจข้อมูลหลายประเภทพร้อมกัน และนำข้อมูลเหล่านั้นมาสร้างหรือจำลองโลก 3 มิติที่มีความต่อเนื่องได้
.
(อ่านต่อในคอมเมนต์)
.
📧 ติดต่อเรา Email: info@jeenthainews.com
.
#WorldLabs #Atlas #AI
.
https://www.facebook.com/share/p/1HNyRhxb5U/