อ่านตรงนี้ก่อนนะครับ ผมรันโมเดลเพื่อใช้ Agent
งั้นไม่ต้องมาบอกว่าทำไมไม่ใช้ Gemini มันฟรีและเร็วกว่า, ก็มันใช้ได้แต่ในเว็บ
แล้วก็ทำไมไม่ใช้ API จาก OpenRouter, Google AI Studio, ... , ใช้ครับถ้าโมเดลที่รันเอง มันไม่ไหว
แล้ว API แบบฟรีก็มีนะ, ลองเอามาเล่นสิครับจะได้กี่ Requests/Day, มันไม่พอเล่น Agent
เริ่มต้นแบบนี้ก่อนครับ CPU มันรัน AI ได้ก็จริง แต่ก็ช้าเว่อรๆ, ถ้าจะเอาไปเล่น Agent นี่คือฝันเลยครับ
พวก Ryzen 8000G ที่มี iGPU จะคำนวณ Prefill ได้เร็วกว่า, แต่ไม่เกี่ยวกับ Ryzen 5000G มันไม่มี WMMA เร่งการคำนวณ
รูปด้านล่างใช้ Ryzen 5 5600 คำนวณ Prefill ด้วย AVX2, Decode ด้วย DDR4-3466, ค่าที่ได้มันต่ำมาก
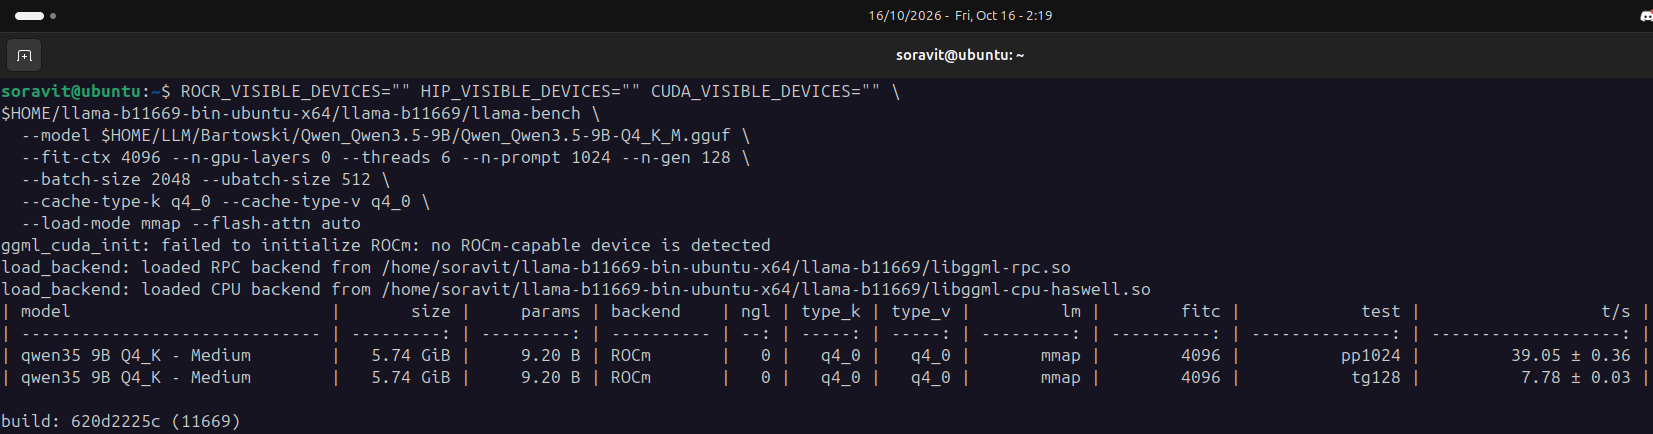
Ryzen 5 5600 + DDR4-3466 รัน Qwen9B-Q4_K_M
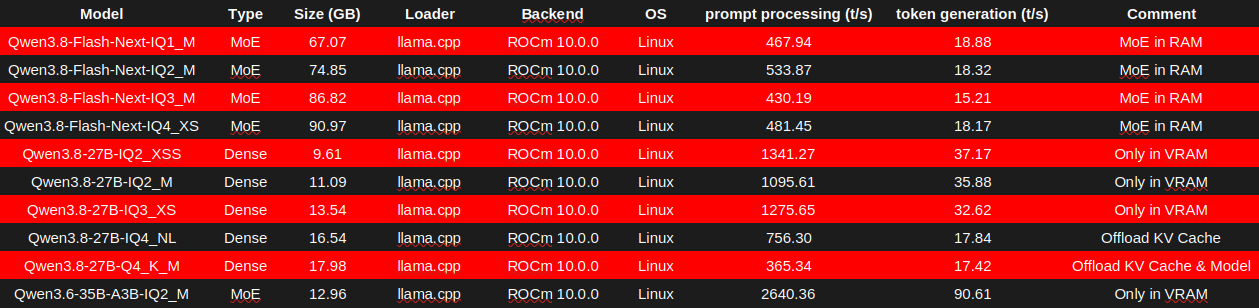
RX 9070 XT (+ CPU offload) รัน Qwen รุ่นต่างๆ
ก็วิธีการรันโมเดลให้มันแรงที่สุดมันจะขึ้นอยู่กับ ชิพ GPU และชิพ VRAM ของการ์ดจอ, สองตัวนี้เป็นตัวกำหนดความเร็ว Prefill และ Decode ของโมเดล
ดูจากรูปบนถ้าผม Offload อะไรบางอย่างที่มันควรอยู่ใน VRAM ลงมาที่ CPU (RAM) ความเร็วมันจะตกลงทันทีแบบชัดเจน, ยิ่งออกเยอะยิ่งตก
คืองั้นการเลือกระดับการ Quantize ของโมเดลถึงสำคัญ มันจะเป็นตัวกำหนดว่าโมเดล Fit ลง VRAM พอดีมั้ย แล้วจะเหลือ Context Size เท่าไร
เพียงพอต่อการใช้งานมั้ย จะได้รัน Session ได้ยาวๆ ไม่ต้องเริ่มใหม่ตลอดๆ, แต่คือมันจะมีจุดหนึ่งที่เรารู้สึกว่าโมเดลมันโง่จังวะ
คุณจะอยากรันโมเดลที่มีขนาดใหญ่ขึ้น ตรงนี้แหละครับที่โมเดลแบบ MoE มันจะเด่นออกมา
ท้าวความก่อนครับโมเดลมันจะมี 2 แบบเป็น Dense และ MoE (Mixture of Experts)
โมเดลแบบ Dense สมมุติ Qwen3.8-27B เวลาการสร้าง 1 token มันจะทำการคำนวณออกมาจากทั้ง 27B พารามิเตอร์, เป็นการคำนวณที่หนักมาก
โมเดลแบบ MoE สมมุติ Qwen3.6-35B-A10B ชื่อมันบอก A10B คือ Active Parameter มีแค่ 10B คือมันทำงานจริงแค่ 10B หนักน้อยกว่าด้านบน
มันจะรันได้เร็วกว่า ดูจากรูปด้านบนได้ (แต่ถ้าเทียบใช้ในการรัน Agent Qwen3.8-27B ดีกว่าค่อนข้างชัดเจน แต่ไม่ใช่ในทุกกรณีนะต้องเทียบเป็นโมเดลไป)
ก็นั่นแหละครับผมรู้สึกว่า Qwen3.8-27B ตัวที่ Quantize แล้ว Fit พอดีกับ VRAM ของผม
มันยังดีไม่พอ เลยพยายามที่จะรัน Qwen3.8-Flash-Next (125B-A6B) ตอนแรกก็กะจะรันเล่นๆ
เพราะว่ายังไงมันก็ถูก Offload ไป CPU คิดว่าคงรันได้ไม่เร็วแน่ๆ แต่คือลองรันแล้วมันอยู่ในจุดที่เร็วพอรับได้ เลยเอามาเขียนกระทู้ครับ
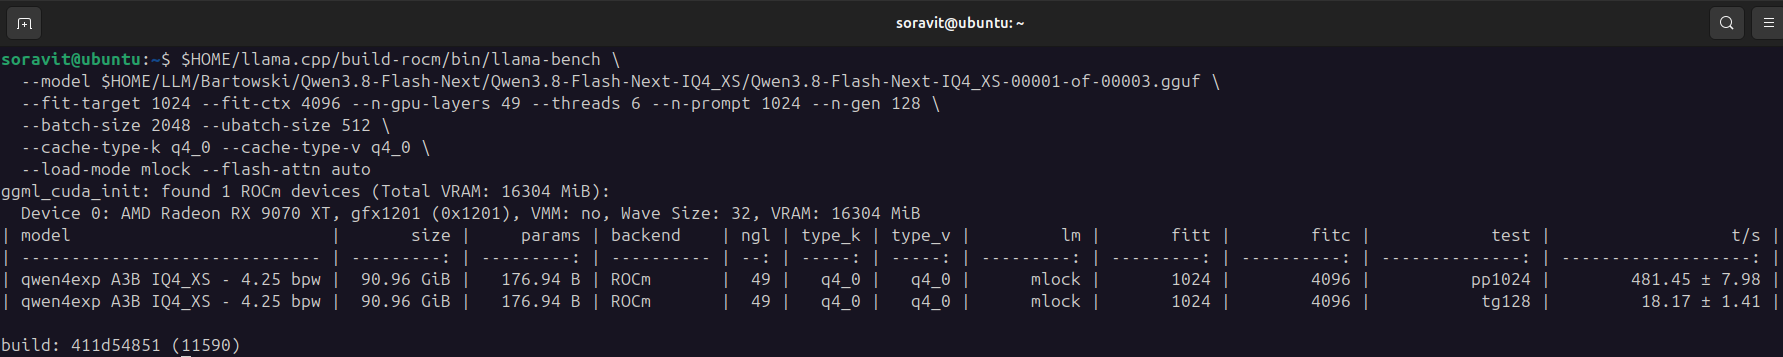
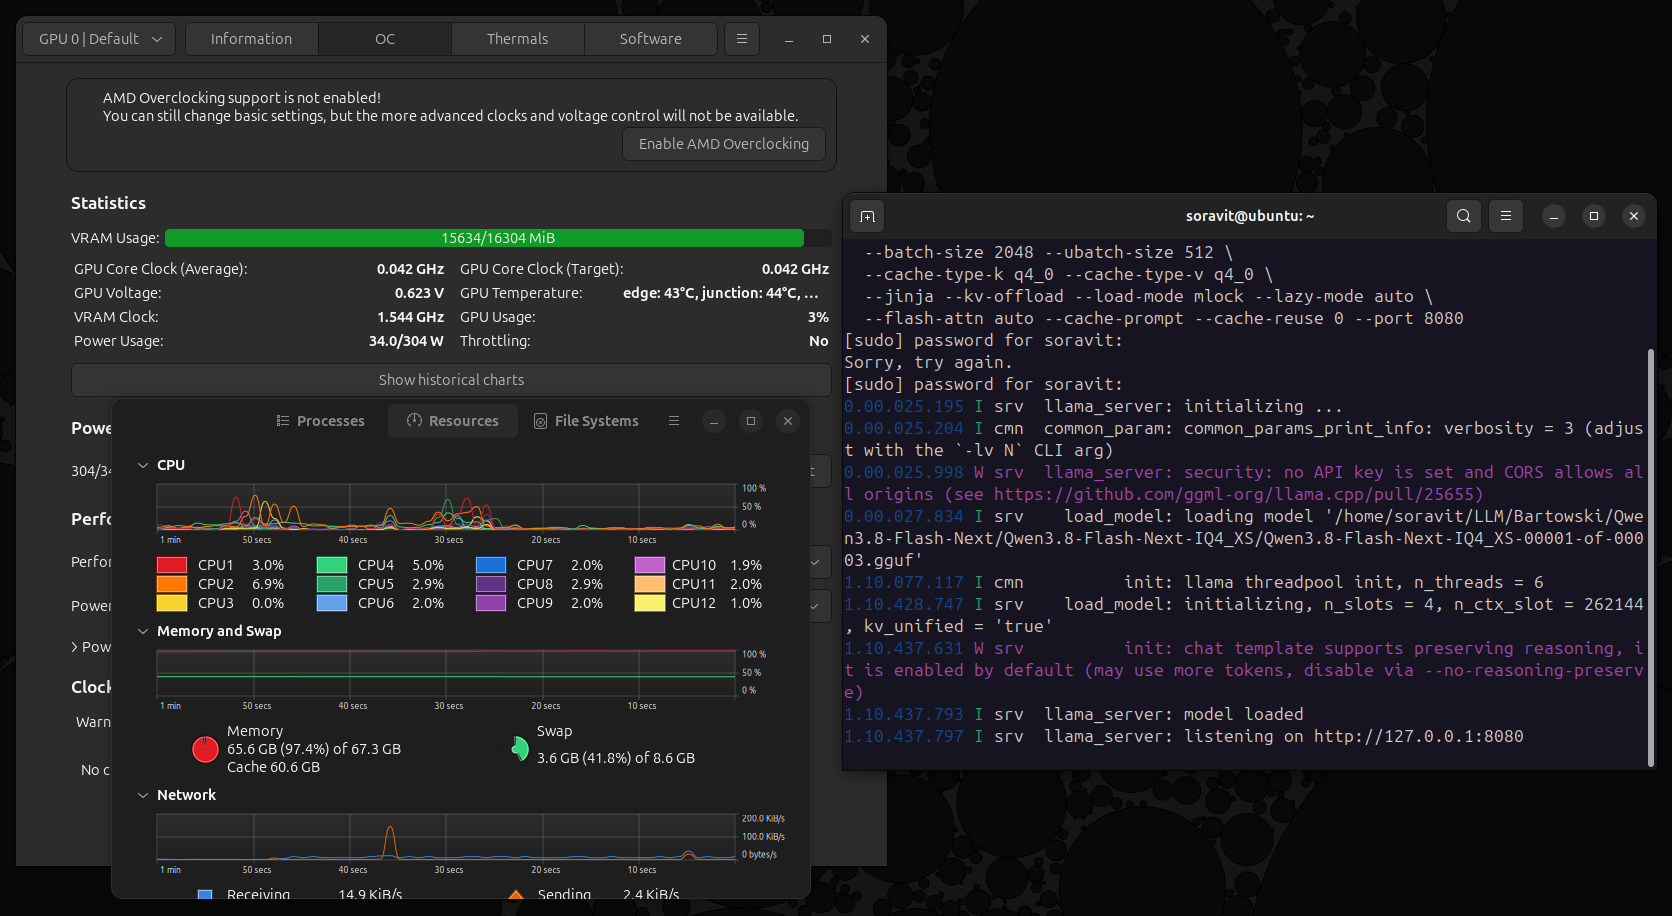
Qwen3.8-Flash-Next-IQ4_XS (90.97GB), โหลดได้แต่โมเดล
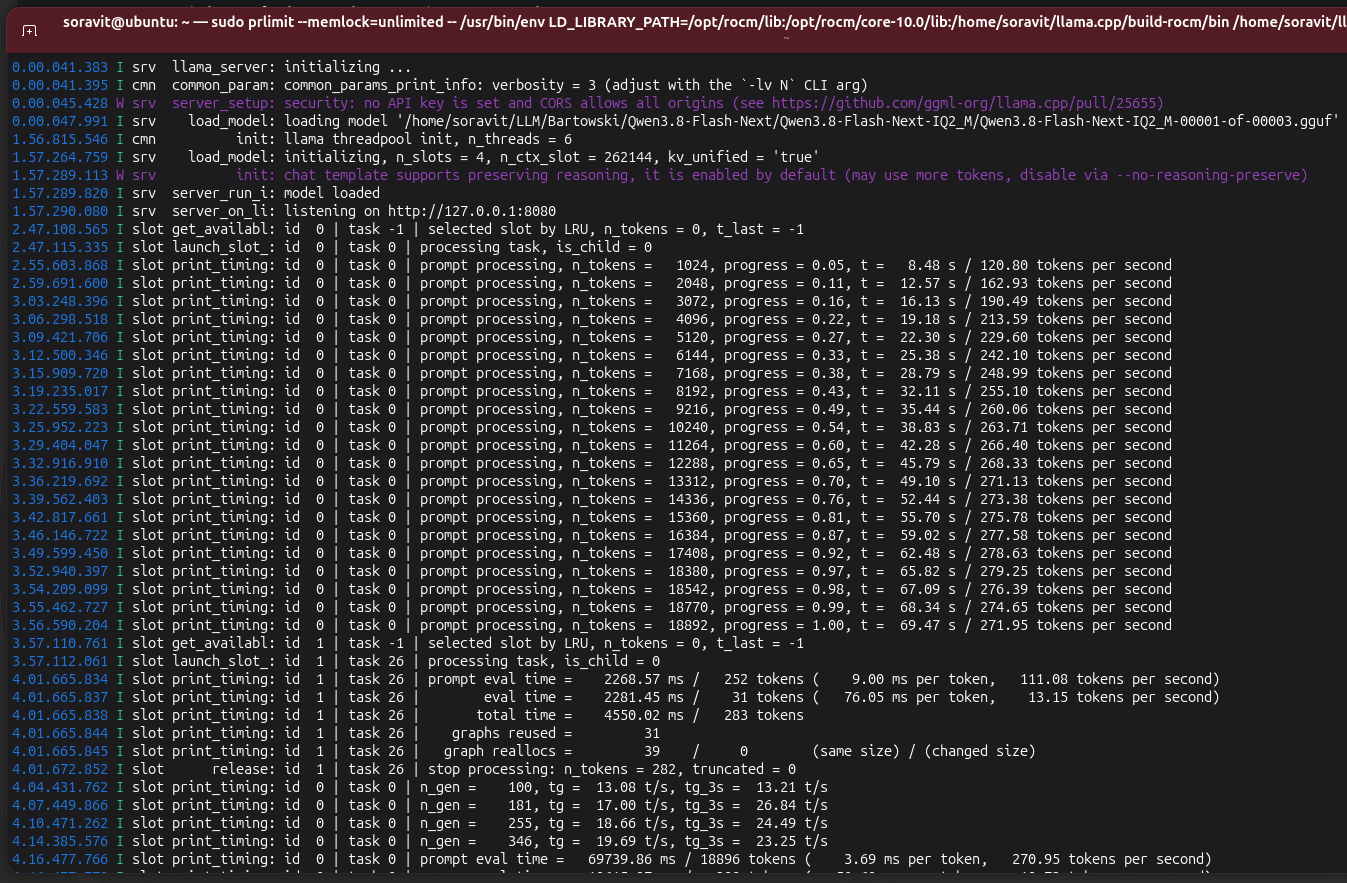
Qwen3.8-Flash-Next-IQ2_M (74.85GB)
pp : <300 tok/s , tg : 15-30 tok/s
[Spoil] คลิกเพื่อดูข้อความที่ซ่อนไว้การเปิด spec-decode : draft-mtp
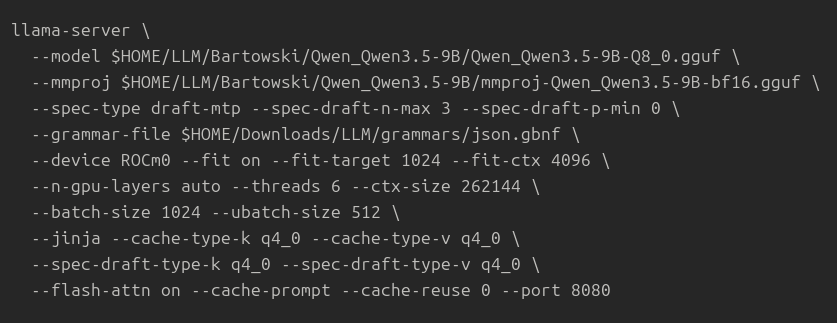
การเปิด spec-decode : ngram-mod
----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
Strata เป็นตัวรันโมเดลที่ปรับแต่งมาเป็นพิเศษสำหรับรัน Qwen3.8-Flash-Next บน Gaming PC ธรรมดา
ความต้องการขั้นต่ำคือ RAM + VRAM 32 GB จะสามารถรัน IQ1_M (Coder) ได้, ไม่รวม KV Cache, Compute Buffer อื่นๆ
แนวคิดการทำงานคร่าวๆ มันจะเก็บตัว Expert ที่ถูกใช้บ่อยไว้บน VRAM, ส่วน Expert ที่ไม่ค่อยได้ใช่จะถูก Offload ไป CPU
KV Cache ที่ Resident อยู่บน VRAM ค่าเริ่มต้นอยู่ที่ 64k ถ้าเพิ่มจะเป็นการแลกเปลี่ยน กับจำนวน Expert ที่ Resident
KV Cache ส่วนที่เหลือจะถูก Offload ไป CPU ทำให้ช่วง Context ก่อนถึง 64k โมเดลจะทำงานได้ไวมากๆ
เปิดและใช้ Spec-Decode แบบ MTP เพื่อทำการเดาคำ ทำให้การอ่านน้ำหนักโมเดล 1 รอบ ได้โทเคนออกมามากขึ้น
จริงๆ แนวคิดนี้สามารถทำจำลองใน llama.cpp ได้ แต่ความเร็ว Prefill, Decode จริงๆ จะสู้ Strata ไม่ได้เลย
ขนาดของโมเดลแปรผันตรงกับความเร็วของโมเดล และแนวคิดคือ ยิ่งโมเดลเล็ก Expert จะอยู่ใน VRAM ได้มากขึ้น ทำให้เร็วขึ้น
เครื่องผม VRAM + RAM 80GB รันได้เต็มที่ IQ3_S ถึงแม้ในเอกสาร จะบอกว่า IQ3_S รันได้ด้วย RAM + VRAM 64GB
เอกสารมันคิดแค่ Expert ของโมเดล ไม่ได้รวมระบบปฏิบัติการ, โปรแกรมที่เปิดอยู่, พื้นที่ส่วนอื่นๆ ที่โมเดลต้องการ
คือคุณสามารถรันโมเดลที่ขนาดใหญ่กว่า VRAM + RAM ของคุณได้นะ, น้ำหนักของโมเดลส่วนเกินมันจะถูกเก็บอยู่ใน SSD
เวลาจะคำนวณโมเดลรอบนึง ก็ต้องวิ่งไปดึงความเร็วมันจะตกเยอะ ก็ต้องลองทดสอบดูเอง ว่าเครื่องคุณเหมาะที่จะรันโมเดลตัวไหน
ค่าเริ่มต้นที่ตัวติดตั้ง Strata เลือกให้ผมจะเป็น UD-IQ4_XS บอกตรงว่าเห็นโมเดลระเบิดตลอดๆ ตอนใช้งาน, คิดว่าเพราะปรับ Context 256k
ใน llama.cpp ผมก็รันโมเดลเต็มที่ได้แค่ IQ2_M (ที่เห็น IQ4_XS โหลดได้แต่โมเดล) งั้นการจะรัน IQ4_XS แล้วจะได้ความเร็วที่ดีเป็นไปไม่ได้นะ
อาจจะเป็นเฉพาการ์ด AMD นะคิดว่าที่ต้องตั้งค่า --vram-reserve-mib 2048, ถ้าน้อยกว่านี้จะเป็นอาการ Crash กลับหน้า Login
Qwen3.8-Flash-Next-IQ3_S (83.60GB)
pp : 1000-1500 tok/s , tg : 30-60 tok/s
----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
Avalon : 98 tokens/s on an AMD RX 7900 XT (PCIe 3.0, Ryzen 7 3800XT, 64 GB DDR4) for Qwen3.8-Flash-Next (125B MoE).
----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
อีกอย่างคือก่อนหน้านี้ผมลองทำ RPC Server ลองรันโมเดลขนาดใหญ่ ด้วยคอม 3 เครื่อง, โมเดลแบบ Dense คิดว่าใช้ได้นะ, แต่ไม่ใช่ MOE
ถ้าแบบ Dense ส่งทีเดียวแบ่ง Layer ที่แต่ละเครื่องถือชัดเจน, MoE จะส่งตามจำนวณ Expert ที่ทำงาน แล้วส่งไปส่งกลับถี่กว่า Latency กินตาย
แล้ว 1Gbps Ethernet มันรับ Payload ที่ Context Size สูงๆไม่ไหว ก็รันในเครื่องเดียว ส่งข้อมูลกันผ่าน PCIe 4.0 กันจบๆ
ทดลองรัน Qwen3.8-Flash-Next (125B-A6B)
งั้นไม่ต้องมาบอกว่าทำไมไม่ใช้ Gemini มันฟรีและเร็วกว่า, ก็มันใช้ได้แต่ในเว็บ
แล้วก็ทำไมไม่ใช้ API จาก OpenRouter, Google AI Studio, ... , ใช้ครับถ้าโมเดลที่รันเอง มันไม่ไหว
แล้ว API แบบฟรีก็มีนะ, ลองเอามาเล่นสิครับจะได้กี่ Requests/Day, มันไม่พอเล่น Agent
CPU : AMD - Ryzen 5 5600
CPU COOLER : GAMDIAS - BOREAS E2-410
MB : GIGABYTE B550M-K (Rev. 1.2)
RAM : XPG - GAMMIX D35, AX4U320032G16A-DTBKD35 (64GB)
RAM COOLER : JONSBO - NF-2 ARGB
GPU : SAPPHIRE - PULSE RX 9070 XT
PSU : Antec - GSK V2 850W
พวก Ryzen 8000G ที่มี iGPU จะคำนวณ Prefill ได้เร็วกว่า, แต่ไม่เกี่ยวกับ Ryzen 5000G มันไม่มี WMMA เร่งการคำนวณ
รูปด้านล่างใช้ Ryzen 5 5600 คำนวณ Prefill ด้วย AVX2, Decode ด้วย DDR4-3466, ค่าที่ได้มันต่ำมาก
Ryzen 5 5600 + DDR4-3466 รัน Qwen9B-Q4_K_M
ดูจากรูปบนถ้าผม Offload อะไรบางอย่างที่มันควรอยู่ใน VRAM ลงมาที่ CPU (RAM) ความเร็วมันจะตกลงทันทีแบบชัดเจน, ยิ่งออกเยอะยิ่งตก
คืองั้นการเลือกระดับการ Quantize ของโมเดลถึงสำคัญ มันจะเป็นตัวกำหนดว่าโมเดล Fit ลง VRAM พอดีมั้ย แล้วจะเหลือ Context Size เท่าไร
เพียงพอต่อการใช้งานมั้ย จะได้รัน Session ได้ยาวๆ ไม่ต้องเริ่มใหม่ตลอดๆ, แต่คือมันจะมีจุดหนึ่งที่เรารู้สึกว่าโมเดลมันโง่จังวะ
คุณจะอยากรันโมเดลที่มีขนาดใหญ่ขึ้น ตรงนี้แหละครับที่โมเดลแบบ MoE มันจะเด่นออกมา
มันจะรันได้เร็วกว่า ดูจากรูปด้านบนได้ (แต่ถ้าเทียบใช้ในการรัน Agent Qwen3.8-27B ดีกว่าค่อนข้างชัดเจน แต่ไม่ใช่ในทุกกรณีนะต้องเทียบเป็นโมเดลไป)
เพราะว่ายังไงมันก็ถูก Offload ไป CPU คิดว่าคงรันได้ไม่เร็วแน่ๆ แต่คือลองรันแล้วมันอยู่ในจุดที่เร็วพอรับได้ เลยเอามาเขียนกระทู้ครับ
pp : <300 tok/s , tg : 15-30 tok/s
[Spoil] คลิกเพื่อดูข้อความที่ซ่อนไว้
ความต้องการขั้นต่ำคือ RAM + VRAM 32 GB จะสามารถรัน IQ1_M (Coder) ได้, ไม่รวม KV Cache, Compute Buffer อื่นๆ
KV Cache ที่ Resident อยู่บน VRAM ค่าเริ่มต้นอยู่ที่ 64k ถ้าเพิ่มจะเป็นการแลกเปลี่ยน กับจำนวน Expert ที่ Resident
KV Cache ส่วนที่เหลือจะถูก Offload ไป CPU ทำให้ช่วง Context ก่อนถึง 64k โมเดลจะทำงานได้ไวมากๆ
เปิดและใช้ Spec-Decode แบบ MTP เพื่อทำการเดาคำ ทำให้การอ่านน้ำหนักโมเดล 1 รอบ ได้โทเคนออกมามากขึ้น
จริงๆ แนวคิดนี้สามารถทำจำลองใน llama.cpp ได้ แต่ความเร็ว Prefill, Decode จริงๆ จะสู้ Strata ไม่ได้เลย
เอกสารมันคิดแค่ Expert ของโมเดล ไม่ได้รวมระบบปฏิบัติการ, โปรแกรมที่เปิดอยู่, พื้นที่ส่วนอื่นๆ ที่โมเดลต้องการ
คือคุณสามารถรันโมเดลที่ขนาดใหญ่กว่า VRAM + RAM ของคุณได้นะ, น้ำหนักของโมเดลส่วนเกินมันจะถูกเก็บอยู่ใน SSD
เวลาจะคำนวณโมเดลรอบนึง ก็ต้องวิ่งไปดึงความเร็วมันจะตกเยอะ ก็ต้องลองทดสอบดูเอง ว่าเครื่องคุณเหมาะที่จะรันโมเดลตัวไหน
ค่าเริ่มต้นที่ตัวติดตั้ง Strata เลือกให้ผมจะเป็น UD-IQ4_XS บอกตรงว่าเห็นโมเดลระเบิดตลอดๆ ตอนใช้งาน, คิดว่าเพราะปรับ Context 256k
ใน llama.cpp ผมก็รันโมเดลเต็มที่ได้แค่ IQ2_M (ที่เห็น IQ4_XS โหลดได้แต่โมเดล) งั้นการจะรัน IQ4_XS แล้วจะได้ความเร็วที่ดีเป็นไปไม่ได้นะ
อาจจะเป็นเฉพาการ์ด AMD นะคิดว่าที่ต้องตั้งค่า --vram-reserve-mib 2048, ถ้าน้อยกว่านี้จะเป็นอาการ Crash กลับหน้า Login
pp : 1000-1500 tok/s , tg : 30-60 tok/s
ถ้าแบบ Dense ส่งทีเดียวแบ่ง Layer ที่แต่ละเครื่องถือชัดเจน, MoE จะส่งตามจำนวณ Expert ที่ทำงาน แล้วส่งไปส่งกลับถี่กว่า Latency กินตาย
แล้ว 1Gbps Ethernet มันรับ Payload ที่ Context Size สูงๆไม่ไหว ก็รันในเครื่องเดียว ส่งข้อมูลกันผ่าน PCIe 4.0 กันจบๆ