ก็เกริ่นก่อนเลยละกันครับ
ถ้าจะเล่นโมเดลทั่วไป Gemini-3.7, Deepseek V4 Flash, ก็ซื้อ API เอาเถอะครับ, ถูกมากกก
ลองหาดูบน OpenRouter, โมเดล Parameter มันสูงแบบไม่สามารถ Host เองได้เลย, แล้วคือมันตอบสนองได้เร็วมาก (ถ้าเลือก Provider ดีๆ)
เร็วพอๆ กับเอาโมเดลเล็กๆ มารันบนการ์ดจอบ้าน, แต่มันจะหลุด Context ยากกว่าเยอะ
API ฟรี ยังมีเลยครับพวก Nvidia Nemotron, Nemotron Ultra 550B (MoE-55B), Nemotron Super 120B (MoE-12B)
เผื่อใครอยากจะลองเล่น Agentic AI สายฟรี, รัน OpenClaw, Hermes Agent,
แต่คุณต้องสู้กับ Latency, Error 429 - Too Many Requests และ Rate Limit - 1000 requests / day
สำหรับผมตอนนี้เล่น LLM แบบ Roleplay เป็นหลักครับ, ก็เน้นแชทสวมบทบาทนั่นแหละ
คือจะไปขอ API ฟรีจาก Google AI Studio มาก็ได้นะ, Rate limit วันนึงก็เล่นไม่หมดหรอก
แต่มันมีข้อเสีย คือเพราะ Gemini มันเป็นโมเดลสำหรับการตอบคำถามแบบ ตรงไป-ตรงมา อารมณ์ร่วมมันก็ดีแหละ
แต่ไม่สุดเท่าโมเดล Finetunes ที่ทำมาเฉพาะสำหรับ Creative Writing, Roleplay มันจะให้ฟีลการโต้ตอบที่ดีกว่า
 โมเดลที่ใช้เปรียบเทียบ
Finetuned : TheDrummer_Anubis-Mini-8B-v1-IQ4_NL.gguf - 4.77 GB
Base Model : allura-forge/Llama-3.3-8B-Instruct
Memory Bandwidth
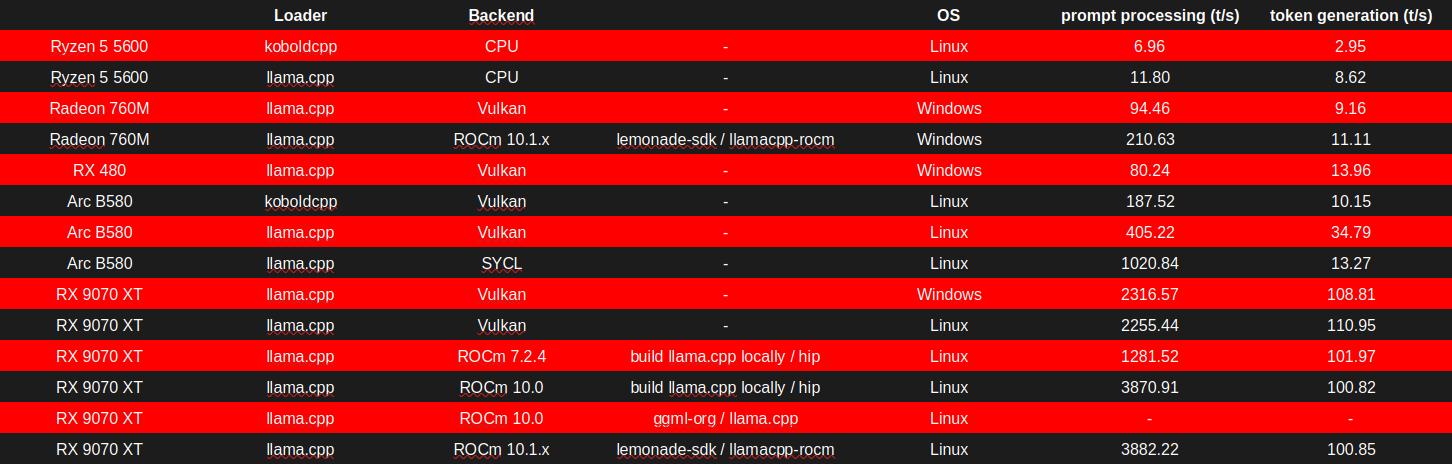
Radeon 760M - DDR5-5600, 32bit (Single-Channel) - 22.4 GB/s
RX 480 - GDDR5, 256bit – 256.0 GB/s
Arc B580 - GDDR6, 192bit – 456.0 GB/s
RX 9070 XT - GDDR6, 256bit – 644.6 GB/s
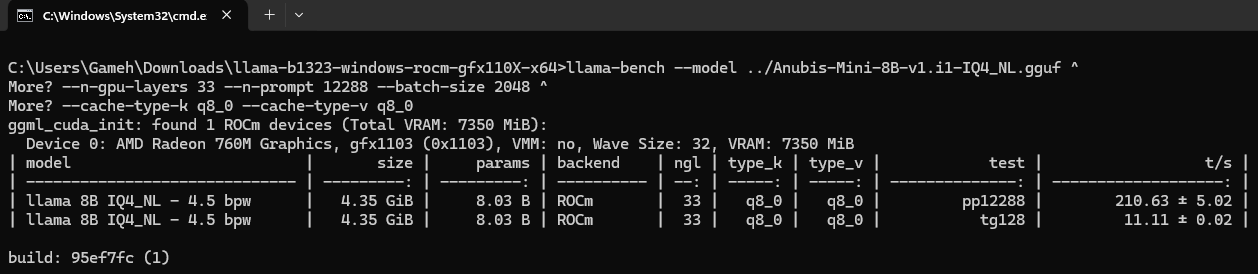
Radeon 760M (iGPU) ทดสอบใน 2 กรณี ที่แตกต่างกัน
Vulkan, เป็นค่าเริ่มต้น ในกรณีที่ยังไม่ติดตั้ง ROCm,
b10488
ROCm 10.x, Pre-built Binaries, ของ
lemonade-sdk / llamacpp-rocm,
b1323
แรงดียุเลยนะพอเปิด ROCm, ประเด็นคือมันใช้ ROCm ได้ด้วย
Arc B580 ทดสอบใน 2 กรณี ที่แตกต่างกัน, มองข้าม koboldcpp ไปเลย
Vulkan, เป็นค่าเริ่มต้น ในกรณีที่ยังไม่ติดตั้ง SYCL,
b10488
SYCL FP16, Pre-built Binaries, ของ llama.cpp,
b10488
SYCL FP16 อ่าน prompt เร็วขึ้นจริง, แต่ตอนจะตอบกลับดันทำได้ช้าลง
คือการ์ด Intel นี่บอกตรงเอาไปแก้รูป, สร้างวีดีโอ ไม่ได้นะ VRAM ระเบิด, สร้างรูปก็ได้แค่บางครั้ง
แล้วพอเอามาเล่น LLM ก็ทำได้ไม่ดีเลย, การ์ดจอมันทำได้แค่เล่นเกมจริงๆ แค่เล่นเกมเลย
GitHub Issue #22413: brutally bad SYCL performance on Battlemage #22413
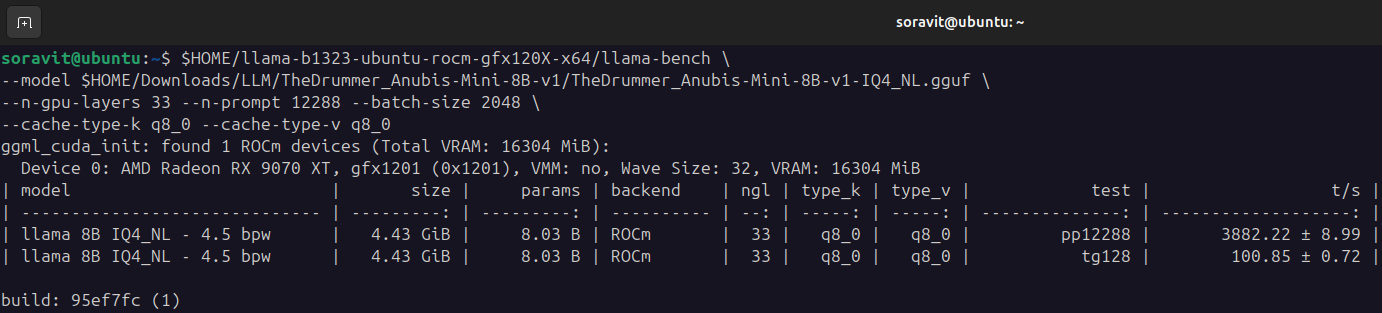
RX 9070 XT ทดสอบใน 3 กรณี ที่แตกต่างกัน
Vulkan, เป็นค่าเริ่มต้น ในกรณีที่ยังไม่ติดตั้ง ROCm, b10488
ROCm 7.2.4, Manual Compile,
Build llama.cpp locally - HIP, ติดตั้ง ROCm ตาม Gemini,
ROCm 7.2.4
ROCm 10.0, Manual Compile,
Build llama.cpp locally - HIP, ติดตั้ง ROCm ตาม Guide,
ROCm 10.0.0
ROCm 10.1, Pre-built Binaries, ของ
lemonade-sdk / llamacpp-rocm,
b1323
ROCm 10.0, Pre-built Binaries, ของ llama.cpp สำหรับ gfx1201 ใช้งานไม่ได้, ใช้ได้เฉพาะรุ่น
ROCm 10.0, เพิ่งเปิดตัว 27/08/26 ไม่กี่วันนี้เอง, prompt processing พุ่งแรงมาก, ตบมือๆ
ในกรณีที่ใช้ Custom Kernel ให้แก้คำสั่งติดตั้ง ROCm 10.0 เป็น
sudo amdgpu-install --usecase=rocm,graphics --gfxversion=all --no-dkms
amdgpu-dkms ทำหน้าทำคอมไพล์และสร้างไดรเวอร์ amdgpu แล้วเสียบเข้ากับ Kernel, มันจะทำให้ติดตั้งไม่ผ่าน
เพิ่มเติม สำหรับแนวคิดของผม ต่อการ์ด
RADEON AI PRO 9700, ตัว GPU มันแรงเท่าชิพของ 9070 XT แหละ
เม็ดแรมก็ชนิดเดียวกัน GDDR6, Buswidth Bandwidth เท่ากันเป๊ะ, งั้นคือความเร็วการประมวลผลมันเท่ากับ 9070 XT แหละ
แต่ AI PRO 9700 VRAM จะเพิ่มเป็นสองเท่า 32 GB, จะทำให้มันรันโมเดลที่ขนาดใหญ่มากขึ้นได้ โดยไม่ถูก Offload ไป CPU
แต่รันโมเดลเต็มที่ก็ไม่เกิน 49B, Q4_K_M,
TheDrummer_Valkyrie-49B-v2.1-Q4_K_M.gguf - 30.2 GB + KV Cache (Context Size ไม่เยอะเท่าไร) + Buffer = VRAM หมด
ถ้าอยากได้ Context Size เพิ่มต้องลดไซส์โมเดล 49B, Q4_K_S,
TheDrummer_Valkyrie-49B-v2.1-Q4_K_S.gguf - 28.6 GB, อะไรก็ว่าไป แลกกับค่า Perplexity ที่เพิ่มขึ้น
เสียเงินซื้อ API เหอะครับ 5555 ถูกกว่าเยอะ ถ้าจะใช้โมเดลทั่วไปอ่ะ, เร็วกว่าด้วยเพราะโมเดลมันอยู่บนเม็ดแรม HBM
ถ้ากังวลเรื่องความเป็นส่วนตัว, อยากรันโมเดลเฉพาะทาง หรือต้องรันโมเดล 24/7 ก็อีกเรื่องครับ
อีกทางเลือกคือเช่า Cloud GPU เหมาะนะสำหรับอารมณ์แบบ อยากลองเล่นโมเดลใหญ่ๆ ถ้าคิดว่าเล่นไม่นานก็คงเลิก
เพิ่มเติม ถ้าเป็นพวก CPU ที่ชื่อ Ryzen AI, NPU จะเป็นสถาปัตย์กรรม XDNA2, พวกนี้จะใช้ FastFlowLM รันโมเดล LLM บน NPU ได้โดยตรง
โมเดลที่รันได้ขึ้นกับโปรแกรม รันได้แต่โมเดลหลักๆ ตัวเล็กๆ การบีบอัดถูกเลือกไว้ล่วงหน้า, ตัวโมเดล Merges Finetunes แปลกๆจะไม่สามารถรันได้
แนวคิด Unified Memory ก็ดีนะคือเรายัด RAM ไปมากเท่าไร, จะยิ่งรันโมเดลได้ใหญ่ขึ้นเท่านั้น
แต่จะแลกมาด้วย เพราะ NPU, iGPU มันสร้างโทเคนได้ช้าอยู่แล้ว ยิ่งรันโมเดลใหญ่ขึ้นจะยิ่งทำงานได้ช้าลง
NPU, iGPU ควรจะใช้โมเดลประมาณ 4B สำหรับผมนะมันเร็วพอดีอยู่แถวๆนั้น, พอดี RAM หมด 16GB คิดว่าเต็มที่ 12B คงช้าจนรอกันไม่ไหว
แล้วก็ความเร็วการสร้างโทเคน ของทั้งคู่จะไม่ต่างกัน เพราะมันติด Bandwidth RAM
อีกอย่างถ้าผมใส่ RAM แบบ Dual-Channel คิดว่าความเร็วการสร้าง token จะพุ่งขึ้นได้อีก
เปรียบเทียบความเร็วการรัน Local LLM ด้วย CPU, GPU, iGPU
ลองหาดูบน OpenRouter, โมเดล Parameter มันสูงแบบไม่สามารถ Host เองได้เลย, แล้วคือมันตอบสนองได้เร็วมาก (ถ้าเลือก Provider ดีๆ)
เร็วพอๆ กับเอาโมเดลเล็กๆ มารันบนการ์ดจอบ้าน, แต่มันจะหลุด Context ยากกว่าเยอะ
API ฟรี ยังมีเลยครับพวก Nvidia Nemotron, Nemotron Ultra 550B (MoE-55B), Nemotron Super 120B (MoE-12B)
เผื่อใครอยากจะลองเล่น Agentic AI สายฟรี, รัน OpenClaw, Hermes Agent,
แต่คุณต้องสู้กับ Latency, Error 429 - Too Many Requests และ Rate Limit - 1000 requests / day
สำหรับผมตอนนี้เล่น LLM แบบ Roleplay เป็นหลักครับ, ก็เน้นแชทสวมบทบาทนั่นแหละ
คือจะไปขอ API ฟรีจาก Google AI Studio มาก็ได้นะ, Rate limit วันนึงก็เล่นไม่หมดหรอก
แต่มันมีข้อเสีย คือเพราะ Gemini มันเป็นโมเดลสำหรับการตอบคำถามแบบ ตรงไป-ตรงมา อารมณ์ร่วมมันก็ดีแหละ
แต่ไม่สุดเท่าโมเดล Finetunes ที่ทำมาเฉพาะสำหรับ Creative Writing, Roleplay มันจะให้ฟีลการโต้ตอบที่ดีกว่า
โมเดลที่ใช้เปรียบเทียบ
Finetuned : TheDrummer_Anubis-Mini-8B-v1-IQ4_NL.gguf - 4.77 GB
Base Model : allura-forge/Llama-3.3-8B-Instruct
Memory Bandwidth
Radeon 760M - DDR5-5600, 32bit (Single-Channel) - 22.4 GB/s
RX 480 - GDDR5, 256bit – 256.0 GB/s
Arc B580 - GDDR6, 192bit – 456.0 GB/s
RX 9070 XT - GDDR6, 256bit – 644.6 GB/s
Radeon 760M (iGPU) ทดสอบใน 2 กรณี ที่แตกต่างกัน
Vulkan, เป็นค่าเริ่มต้น ในกรณีที่ยังไม่ติดตั้ง ROCm, b10488
ROCm 10.x, Pre-built Binaries, ของ lemonade-sdk / llamacpp-rocm, b1323
แรงดียุเลยนะพอเปิด ROCm, ประเด็นคือมันใช้ ROCm ได้ด้วย
Arc B580 ทดสอบใน 2 กรณี ที่แตกต่างกัน, มองข้าม koboldcpp ไปเลย
Vulkan, เป็นค่าเริ่มต้น ในกรณีที่ยังไม่ติดตั้ง SYCL, b10488
SYCL FP16, Pre-built Binaries, ของ llama.cpp, b10488
SYCL FP16 อ่าน prompt เร็วขึ้นจริง, แต่ตอนจะตอบกลับดันทำได้ช้าลง
คือการ์ด Intel นี่บอกตรงเอาไปแก้รูป, สร้างวีดีโอ ไม่ได้นะ VRAM ระเบิด, สร้างรูปก็ได้แค่บางครั้ง
แล้วพอเอามาเล่น LLM ก็ทำได้ไม่ดีเลย, การ์ดจอมันทำได้แค่เล่นเกมจริงๆ แค่เล่นเกมเลย
GitHub Issue #22413: brutally bad SYCL performance on Battlemage #22413
RX 9070 XT ทดสอบใน 3 กรณี ที่แตกต่างกัน
Vulkan, เป็นค่าเริ่มต้น ในกรณีที่ยังไม่ติดตั้ง ROCm, b10488
ROCm 7.2.4, Manual Compile, Build llama.cpp locally - HIP, ติดตั้ง ROCm ตาม Gemini, ROCm 7.2.4
ROCm 10.0, Manual Compile, Build llama.cpp locally - HIP, ติดตั้ง ROCm ตาม Guide, ROCm 10.0.0
ROCm 10.1, Pre-built Binaries, ของ lemonade-sdk / llamacpp-rocm, b1323
ROCm 10.0, Pre-built Binaries, ของ llama.cpp สำหรับ gfx1201 ใช้งานไม่ได้, ใช้ได้เฉพาะรุ่น
ROCm 10.0, เพิ่งเปิดตัว 27/08/26 ไม่กี่วันนี้เอง, prompt processing พุ่งแรงมาก, ตบมือๆ
ในกรณีที่ใช้ Custom Kernel ให้แก้คำสั่งติดตั้ง ROCm 10.0 เป็น
sudo amdgpu-install --usecase=rocm,graphics --gfxversion=all --no-dkms
amdgpu-dkms ทำหน้าทำคอมไพล์และสร้างไดรเวอร์ amdgpu แล้วเสียบเข้ากับ Kernel, มันจะทำให้ติดตั้งไม่ผ่าน
เพิ่มเติม สำหรับแนวคิดของผม ต่อการ์ด RADEON AI PRO 9700, ตัว GPU มันแรงเท่าชิพของ 9070 XT แหละ
เม็ดแรมก็ชนิดเดียวกัน GDDR6, Buswidth Bandwidth เท่ากันเป๊ะ, งั้นคือความเร็วการประมวลผลมันเท่ากับ 9070 XT แหละ
แต่ AI PRO 9700 VRAM จะเพิ่มเป็นสองเท่า 32 GB, จะทำให้มันรันโมเดลที่ขนาดใหญ่มากขึ้นได้ โดยไม่ถูก Offload ไป CPU
แต่รันโมเดลเต็มที่ก็ไม่เกิน 49B, Q4_K_M,
TheDrummer_Valkyrie-49B-v2.1-Q4_K_M.gguf - 30.2 GB + KV Cache (Context Size ไม่เยอะเท่าไร) + Buffer = VRAM หมด
ถ้าอยากได้ Context Size เพิ่มต้องลดไซส์โมเดล 49B, Q4_K_S,
TheDrummer_Valkyrie-49B-v2.1-Q4_K_S.gguf - 28.6 GB, อะไรก็ว่าไป แลกกับค่า Perplexity ที่เพิ่มขึ้น
เสียเงินซื้อ API เหอะครับ 5555 ถูกกว่าเยอะ ถ้าจะใช้โมเดลทั่วไปอ่ะ, เร็วกว่าด้วยเพราะโมเดลมันอยู่บนเม็ดแรม HBM
ถ้ากังวลเรื่องความเป็นส่วนตัว, อยากรันโมเดลเฉพาะทาง หรือต้องรันโมเดล 24/7 ก็อีกเรื่องครับ
อีกทางเลือกคือเช่า Cloud GPU เหมาะนะสำหรับอารมณ์แบบ อยากลองเล่นโมเดลใหญ่ๆ ถ้าคิดว่าเล่นไม่นานก็คงเลิก
เพิ่มเติม ถ้าเป็นพวก CPU ที่ชื่อ Ryzen AI, NPU จะเป็นสถาปัตย์กรรม XDNA2, พวกนี้จะใช้ FastFlowLM รันโมเดล LLM บน NPU ได้โดยตรง
โมเดลที่รันได้ขึ้นกับโปรแกรม รันได้แต่โมเดลหลักๆ ตัวเล็กๆ การบีบอัดถูกเลือกไว้ล่วงหน้า, ตัวโมเดล Merges Finetunes แปลกๆจะไม่สามารถรันได้
แนวคิด Unified Memory ก็ดีนะคือเรายัด RAM ไปมากเท่าไร, จะยิ่งรันโมเดลได้ใหญ่ขึ้นเท่านั้น
แต่จะแลกมาด้วย เพราะ NPU, iGPU มันสร้างโทเคนได้ช้าอยู่แล้ว ยิ่งรันโมเดลใหญ่ขึ้นจะยิ่งทำงานได้ช้าลง
NPU, iGPU ควรจะใช้โมเดลประมาณ 4B สำหรับผมนะมันเร็วพอดีอยู่แถวๆนั้น, พอดี RAM หมด 16GB คิดว่าเต็มที่ 12B คงช้าจนรอกันไม่ไหว
แล้วก็ความเร็วการสร้างโทเคน ของทั้งคู่จะไม่ต่างกัน เพราะมันติด Bandwidth RAM
อีกอย่างถ้าผมใส่ RAM แบบ Dual-Channel คิดว่าความเร็วการสร้าง token จะพุ่งขึ้นได้อีก